Amani IA
An enterprise AI SaaS in development, designed to connect internal knowledge and data analysis while respecting each employee's access rights. Core tenant policy, Gateway routing, shared packages, and local infrastructure are implemented and tested.
Founder, CEO & Developer
Amani IA: enterprise AI with scoped access
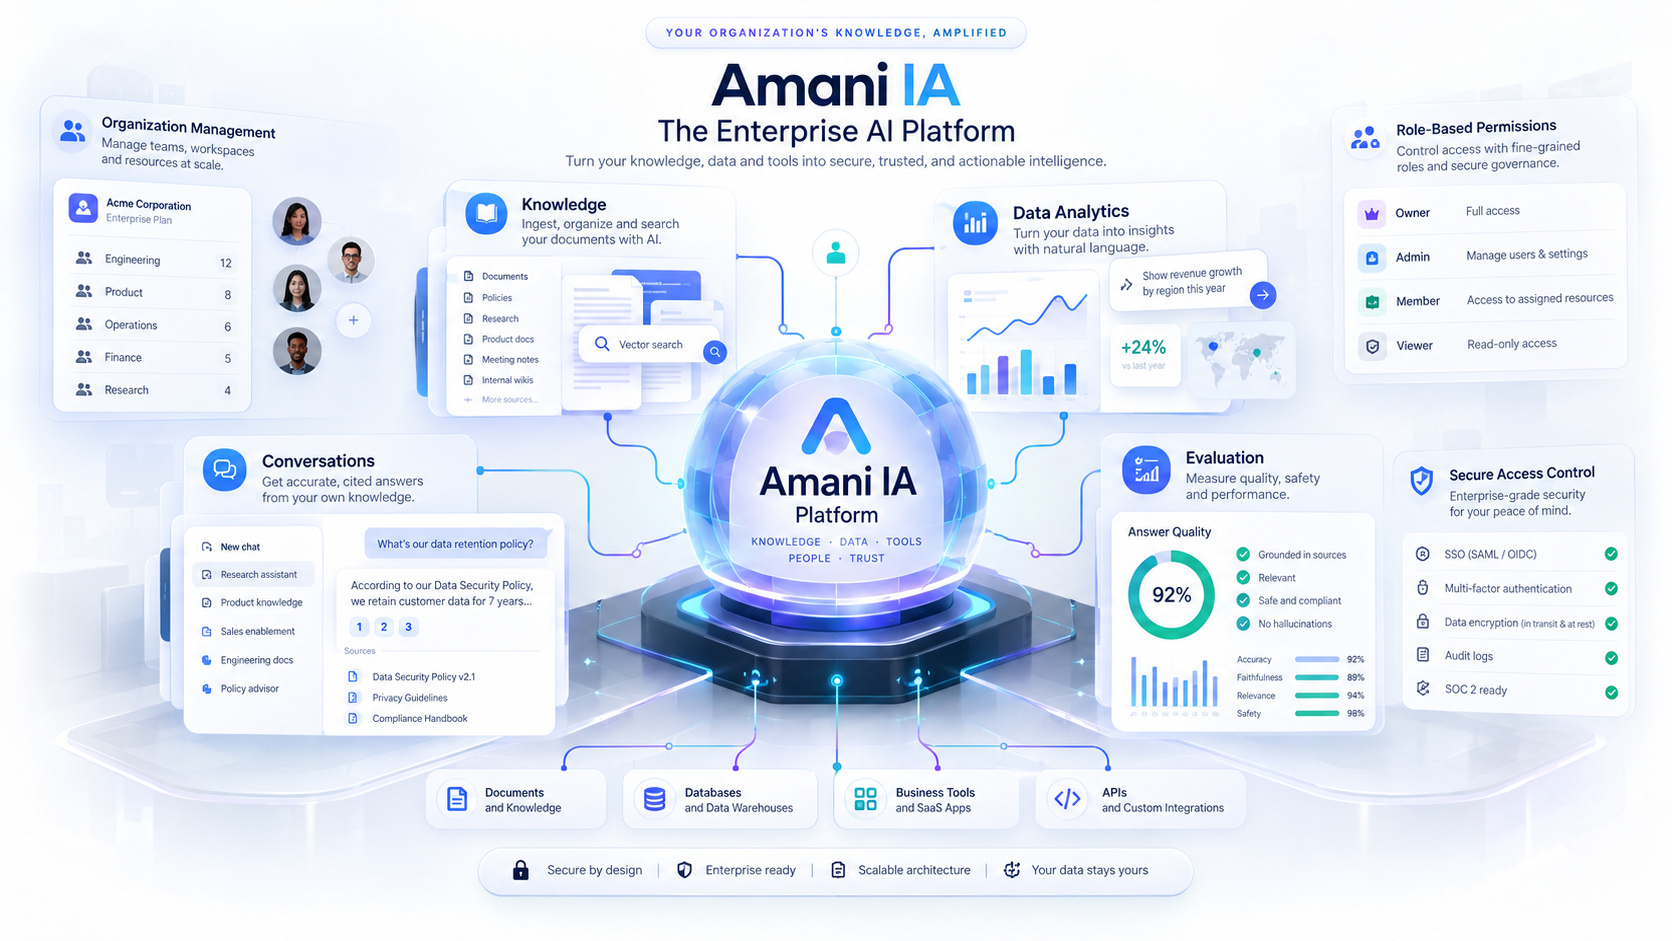
Amani IA is a multi-tenant, plugin-based enterprise AI platform designed to connect company knowledge and business data to secure AI capabilities. Organizations activate the capabilities they need, assign roles to their members, and retain control over which information each person can use.
The AI must never know or reveal information that the requesting user is not authorized to access.
Two employees in the same company can ask the same question and receive different answers because their authorization scopes differ. This principle shapes the service boundaries, data model, retrieval pipeline, background jobs, and citations.
This case study presents Amani IA as a complete engineering system: its product boundaries, multi-tenant security model, service architecture, plugin model, data ownership, AI flows, infrastructure, deployment strategy, and the decisions that connect them. The focus is not a feature checklist; it is the architecture that makes secure enterprise AI possible.
The problem: enterprise AI is an access problem
Company knowledge lives in documents, policies, procedures, reports, spreadsheets, datasets, internal repositories, and external systems. Connecting a language model to these sources is only one part of the problem. The harder questions are who may read a document, invoke a plugin, analyze a dataset, reopen a conversation, or download a generated report—and how another tenant’s data is excluded at every step.
Retrieving everything, sending it to the LLM, and asking it to hide confidential material is unsafe: the confidentiality boundary has already been crossed when the model receives the context. A model’s refusal does not undo that disclosure.
Amani IA follows a different ordering: authorize → filter → retrieve → construct context → generate. The same ordering applies to source references and derived artifacts. Access to a feature is not permission to read every resource behind that feature.
Product direction
The product combines a multi-tenant SaaS model with independently deployable internal services in one monorepo. Its APIs define how the interfaces, plugins, and workers collaborate. Each organization selects capabilities through Knowledge, Data Analytics, Conversations, Connectors, and Evaluation; owners and authorized administrators then delegate their use to members.
Modularity is useful only when the boundaries remain meaningful. Knowledge owns documentary evidence; Analytics owns structured calculations; Conversations owns history; Connectors owns synchronization; Evaluation owns repeatable quality checks. The AI Orchestrator coordinates these capabilities without acquiring ownership of their data.
An installation is a logical organization-level activation. It does not require one plugin container per customer, and the architecture does not assume a marketplace that executes arbitrary third-party code. Product flexibility comes from controlled capabilities and contracts.
Global architecture
Three Next.js applications serve different audiences: Website, Enterprise Portal, and SaaS Admin. Three NestJS platform services provide the API Gateway, Core Platform API, and AI Orchestrator. Five NestJS Plugin APIs own the business domains. Document Processing and the Python Data Engine handle long-running work outside the interactive request path.
PostgreSQL provides relational persistence, pgvector supports vector retrieval, Redis supports transient coordination, and MinIO/S3 holds private objects. The diagram groups storage for readability: it does not grant every service access to every table or object.
Mermaid source
flowchart TD
  Website[Website - Next.js] --> Gateway[API Gateway - NestJS]
  Enterprise[Enterprise Portal - Next.js] --> Gateway
  Admin[SaaS Admin - Next.js] --> Gateway
  Gateway --> Core[Core Platform API]
  Gateway --> AI[AI Orchestrator]
  AI --> Core
  AI --> Knowledge[Knowledge API]
  AI --> Analytics[Data Analytics API]
  AI --> Conversations[Conversations API]
  Connectors[Connectors API] --> Knowledge
  Connectors --> Analytics
  Evaluation[Evaluation API] --> AI
  Knowledge --> Documents[Document Processing worker]
  Analytics --> Python[Python Data Engine]
  Core --> PG[PostgreSQL - service-owned schemas]
  Knowledge --> Vectors[PostgreSQL and pgvector]
  Analytics --> PG
  Knowledge --> Objects[MinIO or S3]
  Analytics --> Objects
  Documents --> Redis[Redis - scoped coordination]
  Python --> Redis
Website
Website is the public product surface: presentation, pricing, plugin catalog, public information, and entry into onboarding. It explains what the organization purchases and what the capabilities do without exposing internal service credentials or privileged administration endpoints.
A published plan description is informational. Core’s current entitlements decide what an authenticated organization can actually activate. Keeping this distinction prevents marketing content or a client-side selection from becoming a source of authorization. Public navigation hands the user to the appropriate authenticated journey rather than creating a parallel policy system.
Enterprise Portal
Enterprise Portal is the customer organization’s workspace. It brings together enabled plugins, knowledge access, datasets and analytics, conversations, and AI interaction. Member administration, teams, roles, and permissions belong to the same organizational context, with actions shown according to the caller’s capabilities.
The selected organization is explicit, especially for users who belong to several companies. Changing it changes the available resources and operations. The dashboard is designed to expose the organization overview, recent activity, and entry points into authorized work. Hiding a control improves clarity; the backend still checks every operation independently.
SaaS Admin
SaaS Admin is the platform operator’s interface for organization management, the plugin registry, moderation workflows, governance, audits, and subscription or entitlement administration. These are platform responsibilities, distinct from running a customer’s internal workspace.
An operator needs enough context to diagnose lifecycle failures or administer a subscription without receiving unrestricted customer documents. Support and moderation actions therefore need explicit purpose, permitted scope, and traceability. Platform status changes must be reflected consistently in Core policy and service behavior; an administration screen cannot bypass that policy.
Frontend architecture
The three Next.js applications intentionally remain separate because they serve different trust and product boundaries. Website is public and mostly informational; Enterprise operates inside an organization context; SaaS Admin performs platform-level operations. They may share visual primitives and typed API clients, but they do not share authorization assumptions.
The browser never becomes the source of truth for permissions. Navigation, buttons, and plugin panels can be hidden when the current user lacks a capability, but every sensitive operation is re-authorized by the backend. Server-only credentials remain outside browser bundles, and frontend API clients speak to the Gateway rather than reaching service databases or privileged internal endpoints.
A shared UI package can keep design language consistent, while an SDK package can centralize generated or maintained clients for versioned API contracts. Keeping those concerns separate from domain services lets the interfaces evolve without importing Core or plugin internals.
API Gateway
The Gateway is the external API entry point. It validates request shapes, establishes the authentication boundary, routes explicit operations, propagates request and correlation IDs, applies CORS and security headers, bounds request bodies, and normalizes public errors. Incoming identity headers are not accepted as proof of an internal caller; forwarded headers follow an allowlist.
It owns transport policy, not organization roles, documents, datasets, or billing rules. Those decisions belong to Core and the plugins. This avoids duplicating domain policy across the edge and the owning service.
The Gateway is stateless with respect to durable business data: it owns no business database or authoritative user session store. Its local-development implementation does keep bounded in-memory rate-limit counters; these reset with the process and are not shared quotas across replicas. Production-wide coordination needs a shared mechanism. The current HTTP integration bounds bodies and downstream responses and applies a deadline without blindly retrying writes.
Core Platform API
Core is the authority for platform policy: users, organizations, memberships, teams, roles, permissions, plugin registry, organization installations, plans, entitlements, subscriptions, and audit. Centralizing these facts prevents each plugin from interpreting organizational identity or commercial access differently.
Core answers organization-level questions such as whether the caller is an active member, holds an operation permission, and can use an entitled plugin. A plugin then checks access to its own resource. Core does not need to own every document ACL or dataset table to remain the platform policy authority.
The implemented organization-creation transaction establishes the organization, owner membership, initial roles, assignments, and audit together. Sensitive changes recheck their policy inside the transaction. Partial failure must not leave an organization without an owner or commit a mutation without its corresponding successful-change audit.
AI Orchestrator
The Orchestrator translates a question into a controlled execution plan. Intent classification distinguishes knowledge requests grounded in documents, data requests requiring calculations, hybrid requests combining both, and general requests that need no private retrieval. Classification selects a route; it never grants access.
The service decomposes the request, resolves available plugins and tools under the authorization context, and chooses serial or parallel execution according to dependencies. Independent retrieval and calculation can run together; a calculation dependent on a retrieved identifier must wait. Budgets, deadlines, and partial-failure rules bound that work.
Authorized results are aggregated with provenance, used to construct the prompt, and passed to the LLM through a provider boundary. The structured response carries the answer, citations, and allowed artifacts. The Orchestrator owns coordination and synthesis, while plugins remain responsible for their resources and current access decisions.
Backend-to-backend communication
The typical path is user → frontend → Gateway → Core or Orchestrator → Plugin API → owned storage or worker → response. Internal placement does not make a call trusted. Each receiving boundary must authenticate the calling service and verify the delegated user, organization, intended action, audience, and validity.
Explicit contracts carry request context and normalized errors. Request IDs identify individual calls; a correlation ID links related calls and jobs. Timeouts stop unbounded waiting. Missing or unverifiable authorization context means denial, including when the policy dependency cannot provide a reliable decision.
Mermaid source
flowchart TD
  User[User] --> Frontend[Next.js frontend]
  Frontend --> Gateway[Gateway - authenticate and validate]
  Gateway --> Core[Core - platform policy]
  Gateway --> AI[Orchestrator - scoped plan]
  AI --> Plugin[Plugin API - resource authorization]
  Plugin --> Core
  Plugin --> Storage[Owned storage]
  Plugin --> Worker[Scoped worker job]
  Storage --> Response[Authorized response]
  Worker --> Response
  Response --> Gateway
The following real contract comes from packages/contracts/src/index.ts. It describes already verified context; TypeScript cannot authenticate a caller merely because an object satisfies this interface.
export interface ServiceRequestContext {
  readonly requestId: RequestId;
  readonly correlationId: CorrelationId;
  /** Identity established by service authentication, not a caller-selected name. */
  readonly callingService: ServiceName;
  readonly timestamp: IsoTimestamp;
  readonly authorization: AuthorizationContext;
}
Service-to-service trust model
Amani IA treats internal communication as an authenticated delegation problem rather than a trusted-network shortcut. The receiving service needs to know which service is calling, which end user is being represented, which organization is active, which operation is requested, and whether that delegated context is still valid.
The transport can evolve—from signed service tokens to workload identity or mutual TLS—but the semantic contract stays the same: callers cannot invent user, organization, role, or permission headers. Reserved headers are stripped or overwritten at the edge, downstream services validate the caller identity, and resource-owning plugins remain responsible for their own authorization decisions.
This also limits confused-deputy failures. A service may be allowed to call another service without being allowed to ask for every resource on behalf of every user. Delegation therefore carries a bounded audience, purpose, correlation context, and expiry instead of a blanket “internal” privilege.
One monorepo, independent boundaries
The architecture groups application code, plugins, workers, shared primitives, infrastructure, and documentation in one repository. The tree below is the organizational map, including reserved areas such as prompts, sdk, and ui; it is not a claim that every directory is an operational package. The active npm foundation comprises three frontends, eight backends, and four shared packages. Python dependencies remain separate from npm workspaces.
amani.ia/
├── apps/
│   ├── gateway/
│   ├── core-api/
│   ├── ai-orchestrator/
│   ├── website/
│   ├── admin/
│   └── enterprise/
├── plugins/
│   ├── knowledge/
│   ├── data-analytics/
│   ├── conversations/
│   ├── connectors/
│   └── evaluation/
├── workers/
│   ├── document-processing/
│   └── data-engine/
├── packages/
│   ├── contracts/
│   ├── types/
│   ├── config/
│   ├── shared/
│   ├── prompts/
│   ├── sdk/
│   └── ui/
├── infrastructure/
├── docs/
└── tests/
Monorepo does not mean monolith. A shared commit can evolve a producer and consumer contract together, but each service still owns its data, runtime configuration, build, and deployment boundary. Import rules matter: convenient filesystem access must not become permission to import another application’s repositories or authorization internals.
Shared packages
@amani/types
Framework-neutral identifiers and value types provide a consistent vocabulary without importing NestJS, Next.js, or an ORM. They describe values, not access grants.
@amani/contracts
API projections, event and job envelopes, errors, and request contexts define cross-service exchanges. Consumers still validate untrusted input at runtime and verify authorization independently. A contract does not carry a shared database model.
@amani/config
Typed configuration helpers validate required values, bounds, protocols, and environments. Configuration errors identify the invalid setting without printing its secret value. Each service chooses the settings it actually needs.
@amani/shared
Small framework-independent utilities handle neutral concerns such as tracing identifiers. They are intentionally narrower than a common business-service layer.
The rule across all four packages is simple: shared packages must never become shared business logic. Otherwise a convenient import couples deployment, persistence, and policy across the entire system.
API contracts, versioning and SDK boundary
Service independence only works when interfaces are explicit. HTTP operations are described through versioned API contracts, while asynchronous work uses versioned event and job envelopes. Breaking changes require a compatibility strategy instead of silently changing a TypeScript type that happens to compile inside the same repository.
packages/contracts defines the shared wire vocabulary; it does not expose ORM entities. packages/sdk is the natural home for generated or maintained service clients once endpoints stabilize. A consumer should depend on an API contract or SDK, not on the provider’s controller, repository, or database schema.
Versioning also applies to events and jobs because queued work can outlive a deployment. Producers include an event/job version, consumers reject unsupported versions deliberately, and migrations of long-running workflows are treated as compatibility work rather than as ordinary refactors.
PostgreSQL and pgvector
PostgreSQL provides relational integrity through foreign keys, constraints, and transactions. UUIDs identify entities; indexes support tenant-scoped lookups and common joins. JSON is useful for bounded metadata that genuinely varies, while identities, relationships, permissions, and lifecycle fields remain explicit. Core uses Drizzle and node-postgres for its own persistence.
pgvector keeps document vectors close to version and resource metadata. Similarity search is one retrieval primitive, not an authorization decision. Candidate selection must incorporate the current tenant and allowed resource set before any excerpt leaves the owning service.
Separate SQL accounts and schemas enforce service ownership. Six service domains have isolated schemas; the extension resides in its own extension schema. This separates service-level privileges from application-level tenant checks. Versioned, checksummed Core migrations use a transaction and advisory lock and run explicitly, making schema changes deliberate rather than an incidental startup race.
Service-owned data
| Owner | Authoritative domain |
|---|---|
| Core Platform | Identities, organizations, memberships, policy, registry, installations, subscriptions, audit |
| Knowledge | Knowledge bases, document versions, permissions, chunks, embeddings, retrieval provenance |
| Data Analytics | Datasets, schemas, data permissions, analysis requests and result metadata |
| Conversations | Threads, messages, attachments and source references |
| Connectors | Connection configuration, synchronization checkpoints and source metadata |
| Evaluation | Evaluation datasets, runs, measurements and regression results |
No service directly modifies another service’s business tables. Reading through another service’s schema is also a boundary violation: it bypasses its resource policy and couples consumers to its migrations. APIs, versioned contracts, and scoped events express collaboration instead.
Ownership also covers deletion and retention. The owning plugin coordinates removal of its rows, objects, indexes, and derived references. Cross-service effects require explicit propagation and reconciliation rather than a hidden cross-schema SQL cascade.
Revocation, retention and derived data
Authorization does not stop at the first read. If access to a document or dataset is revoked, the same restriction must apply to future retrieval, cached results, exports, conversation references, citations, and asynchronous jobs that have not yet completed. A previously generated artifact must not become a permanent bypass around a newer policy decision.
The owning service therefore defines retention and deletion semantics for both primary and derived data. Jobs carry tenant and requester context, sensitive cache entries have bounded lifetimes, and access is revalidated when a result is consumed if the operation can outlive the original authorization decision. Disabling a plugin is a lifecycle change, not an instruction to silently destroy customer data.
Redis: transient coordination
Redis provides the infrastructure role for cache, queues, job coordination, ephemeral state, and distributed rate limiting. It is not the authoritative store for organization membership, permissions, or document ownership. The current Gateway counters remain process-local; the Redis role here describes the shared coordination architecture rather than a claim that those counters already use Redis.
Keys must carry the relevant scope: environment, service, organization, resource or operation, and—when results vary by access—user or authorization-policy version. A cached answer keyed only by its question could leak Alice’s evidence to David. Expiration and invalidation must follow permission and source changes, not merely a convenient cache lifetime.
Queue processing additionally needs an explicit delivery contract, bounded retries, and durable recovery behavior. Choosing Redis as infrastructure does not settle a queue library or make delivery exactly once.
MinIO and S3 object storage
Object storage holds original documents, dataset files, reports, exports, and generated artifacts. PostgreSQL stores their metadata, ownership, version, lifecycle state, and opaque storage references. MinIO provides an S3-compatible local environment; the application contract remains independent of a particular hosting provider.
An organization-scoped key can organize objects by organization, resource, and version, but a path prefix is not an authorization mechanism. The owning API checks the caller and resource before granting a short-lived download or performing a storage operation. Buckets remain private, and storage credentials never become browser credentials.
Derived reports and charts inherit an appropriate access boundary and expiration. Retention, version cleanup, abandoned uploads, temporary files, and deletion propagation need coherent policies so that removing metadata does not leave an accessible confidential object behind.
Configuration and secret boundaries
Configuration is validated per service at startup. Public values, internal endpoints, database credentials, provider keys, and object-storage secrets have different exposure rules; a value needed by a server is not automatically safe for a browser bundle. @amani/config centralizes parsing and validation while each application declares only the variables it actually consumes.
Local development uses reviewed .env.example templates and Docker-managed services. Production credentials are expected to come from a dedicated secret mechanism with service-scoped access and rotation. Logs and error responses never echo secret values, authorization headers, database passwords, provider keys, or object-storage administration credentials.
Core domain model
A User is a platform identity. An Organization defines a tenant. A Membership connects the two, while Teams organize members and Roles collect Permissions. A Plugin identifies a platform capability; a Plugin Installation records its organization-specific lifecycle. Plans describe commercial offers, and Entitlements determine included capabilities under a valid subscription.
These relationships answer different questions: who is the person, which organization is involved, what may they do, and which capabilities are available? Combining them into one global user role would lose the tenant boundary and make exceptions difficult to audit.
The diagram is conceptual; many-to-many relationships use explicit join tables in persistence. Team grouping does not itself grant a permission.
Mermaid source
flowchart TD
  User[User] --> Membership[Membership]
  Organization[Organization] --> Membership
  Organization --> Team[Team]
  Team --> Membership
  Membership --> Role[Role assignments]
  Role --> Permission[Permissions]
  Organization --> Installation[Plugin Installation]
  Plugin[Plugin registry] --> Installation
  Organization --> Subscription[Subscription]
  Plan[Plan] --> Subscription
  Plan --> Entitlement[Entitlements]
  Entitlement --> Plugin
Memberships and organizational context
User and Membership are separate because one identity can belong to several organizations with different responsibilities. Alice can be an HR Manager in Organization A and a Member in Organization B. Her identity remains the same; the effective permission set changes with the selected organization.
Membership status also matters. Suspending or removing a membership must stop its organization-scoped access even when the underlying user account remains active elsewhere. A request therefore cannot infer authority from user identity alone, from an email domain, or from the most privileged role the user holds in another tenant.
Each operation resolves the organization and its current membership before evaluating roles. That context accompanies downstream requests and jobs, preventing an otherwise valid user from substituting a resource identifier from a different organization.
Roles and permissions
Owner, Admin, and Member provide organizational starting points. Custom roles express responsibilities such as HR management or document curation. A membership can hold several roles, and effective permissions are resolved in its organization. Deny-by-default means the absence of a grant is a denial, not an invitation to infer access from a job title.
Core permissions include members.read, members.manage, roles.manage, plugins.use, and plugins.manage. Resource capabilities such as documents.read and datasets.read illustrate the plugin-level permission vocabulary; they still require a check against the particular document or dataset.
Delegation must also be authorized. Non-owner role managers cannot grant permissions beyond their own authority, administrator assignment is owner-controlled, and ordinary membership operations protect ownership. A role editor must make both the operation and its organizational scope understandable.
Platform roles versus organization roles
An Amani platform administrator manages the SaaS. An organization owner or administrator manages a customer workspace. These identities may coexist on a user account, but they belong to different authorization domains.
Platform privileges do not automatically grant membership of every customer organization or permission to read its documents. Support actions require an explicit, narrowly scoped path with suitable audit; a broad platform role must not become an invisible data-access bypass. Conversely, an organization owner cannot change the platform-wide plugin registry or another tenant’s subscription merely because they own their own workspace.
Keeping these role systems separate makes both user expectations and policy tests clearer.
Authorization flow
Authorization is a chain of checks, not one boolean stored on the user. Establish identity, resolve organization, verify active membership, compute effective roles and permissions, check plugin availability and entitlements, then authorize the requested resource. Any failed condition stops data access.
Gateway may reject early, but the owning service remains responsible for enforcing the current decision. A previously successful request, stale cache entry, or queued job is not a permanent grant. A mutation can require a fresh check within its transaction, and a citation download requires a fresh resource check.
Mermaid source
flowchart TD
  Request[Request] --> Identity[Verified identity]
  Identity --> Organization[Selected organization]
  Organization --> Membership[Active membership]
  Membership --> Roles[Effective roles]
  Roles --> Permissions[Operation permission]
  Permissions --> Plugin[Plugin state and entitlement]
  Plugin --> Resource[Current resource authorization]
  Resource --> Result[Scoped operation and result]
  Identity -.-> Deny[Deny on failed or unverifiable check]
  Membership -.-> Deny
  Permissions -.-> Deny
  Plugin -.-> Deny
  Resource -.-> Deny
Permission-aware AI
Alice and David work for the same organization and ask: “What explains the increase in personnel costs?” Alice is authorized to read HR compensation reports. David can read general staffing and project reports but has no payroll access. The shared question does not imply shared evidence.
Alice’s authorized context may include compensation changes. David’s context must exclude payroll documents, salary columns, restricted excerpts, and derived artifacts that would expose those values. His response can discuss the permitted staffing evidence or explain that the available sources are insufficient. It must not hint at confidential figures by presenting a forbidden citation or a revealing aggregate.
Same question + same organization + different permissions = different authorized context = possibly different answer. Filters belong before retrieval and computation, and caches must preserve that distinction. Revoked access must also affect saved references and subsequent turns.
The LLM is not the security boundary.
Mermaid source
flowchart TD
  Question[Same question in the same organization] --> Alice[Alice - HR scope]
  Question --> David[David - general scope]
  Alice --> HR[Authorized HR and general sources]
  David --> General[Authorized general sources only]
  HR --> ContextA[Alice context]
  General --> ContextD[David context]
  ContextA --> AnswerA[Answer with authorized HR evidence]
  ContextD --> AnswerD[Answer limited to general evidence]
Plugin architecture: six separate conditions
A capability passes through six separate questions:
- Does the plugin exist and remain available in the platform registry?
- Is it included in this organization’s entitlement under a valid subscription?
- Does the organization have an installation record?
- Is that installation enabled and operationally active?
- Does this user have permission to invoke the plugin?
- Can this user access the requested resource and operation?
A catalog entry describes availability, a plan describes commercial eligibility, an installation records organization configuration, and user/resource policy governs actual use. None substitutes for the next. An enabled Knowledge plugin must not make all company documents readable by every member.
Core owns registry and installation policy; the plugin owns its resources. Manifests describe version, compatibility, permissions, and dependencies as validated metadata rather than executable grants.
Plugin lifecycle
A registered capability can be selected for an organization, enter a pending request, be provisioned, and become active. Suspension blocks use while preserving context. Disabling withdraws access without silently deleting the customer’s data. Failed provisioning must remain visible and recoverable under an idempotent command.
These are branches, not a mandatory progression from active through every failure state. In Core terminology the pending installation is requested; catalog registration is separate from installation state. Cleanup uses deprovisioning, with retention and purge handled explicitly. Updating the control-plane state alone does not prove every resource has been provisioned.
Mermaid source
flowchart TD
  Registry[Registered in catalog] --> Pending[Pending request - requested]
  Pending --> Provision[Provisioning]
  Provision --> Active[Active]
  Provision --> Failed[Failed]
  Failed --> Provision
  Active --> Suspended[Suspended]
  Suspended --> Active
  Active --> Disabled[Disabled]
  Suspended --> Disabled
  Disabled --> Cleanup[Deprovisioning under retention policy]
Organization onboarding
Onboarding turns an authenticated account into a usable organization workspace. Organization creation establishes the owner and baseline policy atomically. Plan selection then determines eligible plugins; invitations and role assignments determine who can use them. A newly invited member should not inherit broad access just because onboarding succeeded.
The entire product journey spans more than one transaction. External billing and plugin provisioning need visible states, retries, and compensating actions instead of pretending a database rollback can undo every remote side effect. Progress should reflect completed steps, and restarting a failed step should not create duplicate organizations or installations.
Mermaid source
flowchart TD
  Account[Authenticated account] --> Organization[Create organization]
  Organization --> Owner[Establish owner and baseline policy]
  Owner --> Plan[Select plan and entitlements]
  Plan --> Plugins[Select and activate plugins]
  Plugins --> Invitations[Invite team members]
  Invitations --> Roles[Assign organization roles]
  Roles --> Permissions[Verify effective permissions]
  Permissions --> Workspace[Enter authorized workspace]
Knowledge Plugin
Knowledge is designed around knowledge bases, document metadata, versions, storage references, permissions, ingestion orchestration, chunks, embeddings, retrieval, and citations. Initial document formats are PDF, DOCX, TXT, and Markdown. The original remains traceable independently of the extracted representation.
A document is more than uploaded text. Its organization, version, access policy, processing state, and source reference are necessary to explain both what an answer used and why the caller was allowed to use it. Each chunk inherits sufficient provenance to resolve its source and access boundary.
Knowledge owns that lifecycle and exposes authorized operations through its API. The Orchestrator consumes selected evidence; it does not become the document repository or rewrite Knowledge’s access policy.
Document ingestion
The ingestion path validates the caller, file type, size, and target knowledge base before accepting an upload. It stores the private original in MinIO/S3 and records versioned metadata before scheduling a scoped job. The worker extracts, normalizes, chunks, and embeds content, then prepares the index under Knowledge’s ownership.
Database and object storage writes are not one atomic transaction. A robust lifecycle records intermediate states and reconciles abandoned objects or incomplete jobs. A document becomes searchable only when its version and authorized index are consistent. Reprocessing should replace or version derived content rather than duplicate it indefinitely.
Mermaid source
flowchart TD
  Upload[Upload] --> Validate[Validate identity file and target]
  Validate --> MinIO[Private original in MinIO or S3]
  MinIO --> Metadata[Versioned document metadata]
  Metadata --> Job[Scoped ingestion job]
  Job --> Worker[Document worker]
  Worker --> Extract[Extraction]
  Extract --> Normalize[Normalization]
  Normalize --> Chunk[Chunking with provenance]
  Chunk --> Embed[Embedding generation]
  Embed --> Index[pgvector index under Knowledge ownership]
  Index --> Search[Searchable authorized version]
Document Processing worker
The document worker isolates expensive extraction, normalization, chunking, embedding work, and indexing preparation from the API’s response time. The API accepts bounded work and exposes status; the worker executes it under a resource and time budget.
Normalization must preserve useful provenance rather than erase the relationship with pages or sections. Chunking balances searchable context with traceability. Embedding jobs bind results to a document version and model configuration so that a reindex does not silently mix incompatible vectors.
The worker updates status through a defined ownership contract. It does not receive unrestricted access to all tenants or every service schema. Unsupported or malformed documents produce a visible failure state, while retries keep the same logical operation and must revalidate access before publishing results.
Secure RAG flow
Retrieval-augmented generation combines a question with relevant evidence. In Amani IA, Gateway establishes the caller, the Orchestrator carries the authorization context, and Knowledge performs tenant- and resource-filtered retrieval. Only authorized chunks, provenance, and citation references enter prompt construction.
The model can synthesize supplied evidence, but it cannot expand the caller’s scope. Retrieved text is untrusted content, not a source of privileged instructions. An injected instruction inside a document must not authorize a new tool or resource. The answer should express insufficient evidence when appropriate, and citation resolution must recheck source access when opened.
Mermaid source
flowchart TD
  Question[Question] --> Gateway[Gateway]
  Gateway --> AI[Orchestrator]
  AI --> Auth[Verify organization plugin and resource scope]
  Auth --> Knowledge[Knowledge API]
  Knowledge --> Search[Filtered vector search]
  Search --> Chunks[Authorized chunks]
  Chunks --> Citations[Source versions and citation references]
  Citations --> Prompt[Bounded prompt context]
  Prompt --> LLM[LLM generation]
  LLM --> Answer[Grounded answer]
  Answer --> Open[Reauthorize when opening a citation]
AI provider abstraction
Separate provider boundaries cover LLM generation, embeddings, and optional reranking. The application describes the operation it needs while an adapter handles a provider’s request format, credentials, response mapping, timeouts, and usage accounting. A vendor-specific SDK must not define the platform’s permission model.
This separation supports deterministic test doubles, provider comparison, and deployment choices without embedding one vendor throughout the plugins. It does not make providers interchangeable without consequences: context limits, output formats, embedding dimensions, tokenization, privacy terms, and quality differ. Changing an embedding model can require reindexing; a reranker receives only candidates already authorized for the caller.
Provider selection therefore belongs alongside evaluation and operational constraints, not just a configurable model name.
Prompt and model governance
Prompts are treated as versioned application assets rather than scattered strings inside controllers. System instructions, retrieval formatting, citation requirements, and task-specific templates belong behind explicit interfaces so changes can be reviewed, tested, and associated with evaluation results.
Model choice remains a runtime policy concern. Different tasks may use different providers or model classes according to capability, latency, cost, or data-governance constraints. None of those model settings can grant data access: the authorization boundary has already been enforced before prompt construction.
Data Analytics Plugin
Data Analytics owns CSV/XLSX datasets, storage references, detected schemas, profiling metadata, permissions, analysis requests, and result metadata. Profiling exposes column types, missing values, and relevant limitations before an operation is executed. Structured data needs reproducible calculations rather than conversion of every cell into RAG text.
Authorization covers the dataset, the requested operation, and applicable row or column restrictions. Sensitive projections are removed before data reaches the engine. Aggregation also needs care: a small-group total can disclose information even if individual rows are hidden. Results, visualizations, and downloads retain the appropriate access policy.
Mermaid source
flowchart TD
  File[CSV or XLSX] --> Storage[Private object storage]
  Storage --> Metadata[Dataset metadata and schema]
  Metadata --> Profile[Profiling]
  Profile --> Auth[Dataset operation and row-column authorization]
  Auth --> Plan[Validated analysis plan]
  Plan --> Python[Python Data Engine]
  Python --> Result[Result and provenance]
  Result --> Visualization[Authorized visualization or export]
  Result --> Response[Structured response and explanation]
Python Data Engine
The data engine separates Python’s analytical ecosystem from the Node.js API runtime. Pandas and Polars are candidate tools for tabular processing; DuckDB can support local analytical queries when the workload justifies it. These are implementation options, not a requirement to run every library for every job. FastAPI is suitable when an authenticated HTTP boundary is chosen; a documented queue protocol can provide another transport.
Explicit Node/Python contracts describe dataset version, allowed projection, validated filters, operation, limits, job identity, and result shape. The LLM can propose an analysis intent, but the backend must translate it into an allowlisted deterministic operation. It cannot freely select filesystem paths, SQL connections, modules, or network destinations.
Arbitrary LLM-generated Python must not execute against customer data without strong isolation. The initial design avoids that execution model and constrains memory, duration, filesystem, network, and permitted inputs even for approved operations. Temporary outputs need cleanup and reauthorization before publication.
Conversations Plugin
Conversations owns threads, messages, history, attachments, citations, and resource references. It records enough provenance to explain an answer without turning stored history into an unrestricted copy of every source. Conversation ownership and sharing policy are distinct from permission to open each attached document or generated artifact.
Reopening a conversation is an authorization operation. If Alice loses access to a cited report, its presence in an old answer must not restore that access. Subsequent model context, exports, attachments, and citation resolution need current checks and an explicit policy for stored answer content.
The conversation lifecycle also distinguishes accepted requests, partial output, completed answers, and failures. Persisting a message does not imply that a tool succeeded or that all cited evidence remains available.
Connectors
Connectors integrates external enterprise sources through organization-specific configuration. A connection records its source identity, permitted scope, synchronization policy, checkpoints, and references to protected credentials. Stable source identifiers and versions support deduplication and updates without relying on a display name.
The connector transfers documents to Knowledge or datasets to Analytics through their contracts. It does not write their business tables directly. Synchronization must preserve source permissions and propagate revocation, deletion, and version changes; importing content must not silently broaden its audience.
Vendor-specific adapters sit behind this boundary. Network restrictions, credential rotation, webhook authenticity, bounded pagination, retries, and reconciliation are necessary parts of the contract. The architecture deliberately avoids promising a particular external vendor before its access model and synchronization behavior are validated.
Evaluation Plugin
Evaluation makes quality changes observable and repeatable. Evaluation datasets pair questions with authorized evidence, expected properties, and synthetic user scopes. Runs compare retrieval quality, grounding, citation support, answer behavior, latency, and cost under recorded model, prompt, and index versions.
A fluent answer is not sufficient. Tests should distinguish missing relevant evidence, unsupported claims, misleading citations, and unauthorized disclosure. Comparing identical questions across different permissions is essential to detecting regressions that an ordinary relevance benchmark would miss.
Evaluation uses service interfaces with bounded identities rather than bypassing policy through direct SQL. Results need reproducible inputs and reviewable failure cases. This establishes a method for measuring progress; it does not invent a quality score, production benchmark, or customer outcome.
Asynchronous processing
An API validates and accepts a task, places a scoped message on a queue, and returns a job reference. A worker processes it, records progress and results through the owner’s contract, and exposes a final outcome. This keeps expensive work out of the request deadline without losing accountability.
Retries preserve job identity and use idempotency keys where appropriate. Correlation IDs connect acceptance to execution and publication. Tenant scope is mandatory; authorization is revalidated at execution and before publishing results because membership or source permissions may change while a job waits. Failures need bounded attempts and an inspectable terminal state.
Mermaid source
flowchart TD
  API[API validates and accepts] --> Queue[Scoped queue message]
  Queue --> Worker[Worker revalidates scope]
  Worker --> Process[Bounded idempotent processing]
  Process --> Result[Owned result and status]
  Process --> Retry[Retry policy or terminal failure]
  Retry --> Queue
  Result --> Access[Reauthorize result access]
This real JobMetadata interface from packages/contracts/src/index.ts records provenance and execution metadata. It is not a trusted snapshot of permissions or a substitute for the queue’s delivery protocol.
export interface JobMetadata {
  readonly jobId: JobId;
  readonly jobType: string;
  /** Positive integer schema version. */
  readonly jobVersion: number;
  readonly organizationId: OrganizationId;
  readonly requestedBy: UserId;
  readonly correlationId: CorrelationId;
  readonly createdAt: IsoTimestamp;
  /** One-based execution attempt; retries retain the same jobId. */
  readonly attempt: number;
  readonly owner: ServiceName;
  readonly resourceId?: ResourceId;
  readonly action?: string;
  readonly resourceVersion?: string;
  readonly idempotencyKey?: string;
  readonly expiresAt?: IsoTimestamp;
}
Error handling and resilience
| Situation | Public behavior |
|---|---|
| Authenticated caller lacks permission | A 403 denial without exposing protected resource details |
| Invalid upstream behavior or malformed contract response | A normalized 502-class backend error |
| Required backend unavailable | A controlled 503-class unavailability response |
| Downstream deadline exceeded | A 504 timeout with trace identifiers |
These categories express error semantics; exact mapping belongs to each validated endpoint contract. Raw SQL errors, provider bodies, stack traces, and credentials must not cross the public boundary. A malformed successful HTTP response is still a failed contract and must not be passed through as trusted data.
Calls have deadlines and bounded response sizes. Non-idempotent operations cannot be blindly retried: a timeout may occur after the remote write committed. Recovery requires an operation identity, idempotency contract, or reconciliation. Degraded behavior must never mean skipping authorization because Core is unavailable.
Observability
A useful operational event identifies request ID, correlation ID, service, environment, route, status, and duration. Minimal organization or user metadata can help investigations when appropriately authorized, pseudonymized where needed, and retained for a defined purpose. Correlation links a frontend request to backend calls and asynchronous work without requiring their payloads.
Tokens, passwords, secrets, document text, and confidential datasets must never enter routine logs. Logging the entire request body to debug a failure would defeat the confidentiality design. Model prompts and raw provider responses deserve the same treatment as the sensitive evidence they may contain.
Health checks distinguish process liveness from dependency readiness. Metrics and traces support diagnosis of slow retrieval, queue backlog, upstream failures, and costly model calls. Audit records serve accountability for sensitive changes; they are not interchangeable with verbose debug logs or proof of a fully deployed telemetry stack.
CI/CD and release engineering
The monorepo pipeline validates the boundaries that make independent deployment safe: linting, type checking, unit and integration tests, contract compatibility, build output, and container construction. Changes to a shared contract can therefore be checked against multiple consumers before a release is cut.
Services are versioned and deployed independently even though they share one Git history. Database migrations are explicit deployment steps owned by the service that owns the schema. A release should not assume that every service updates at the same instant, so backward-compatible contracts and controlled rollout order matter.
Security checks belong in the same delivery path: dependency review, secret hygiene, container scanning where available, and policy-focused tests prevent the CI pipeline from becoming only a compilation check.
Security model
The design combines several independent controls rather than relying on one trusted component:
- Deny by default and least privilege: absence of a verifiable grant stops an operation; service credentials carry only the access their owner needs.
- Tenant isolation and service-owned data: organization context is enforced in queries and resource checks, while separate SQL roles prevent cross-service table access.
- Authenticated backends: network location and caller-supplied identity headers are not proof. Service identity and bounded user delegation require verification.
- Plugin and resource authorization: capability availability, subscription entitlement, user permission, and resource scope are separate checks.
- Authorization before AI: retrieval, reranking, analysis, prompt construction, and citations stay inside the allowed evidence set.
- Scoped caches and jobs: cached results and queued work preserve tenant and permission boundaries, with invalidation and revalidation after access changes.
- Safe audit and secrets: record necessary metadata, protect credentials, and avoid placing sensitive payloads in logs or frontend bundles.
The LLM cannot relax these rules. Model output and retrieved instructions remain untrusted inputs to controlled application logic. Security assertions need denial tests, including indirect disclosure through aggregates, saved history, attachments, and exports.
Testing strategy
Testing follows the boundary being claimed. Unit tests cover deterministic helpers and policy decisions. Service/domain tests exercise lifecycle rules and transaction behavior. Real-database integration checks constraints, migrations, schema privileges, and rollback. HTTP and contract tests validate request parsing, response projections, authentication rejection, and error normalization.
The implemented Core and Gateway suites exercise backend integration and organization-level denials. The wider product test strategy extends that evidence to plugin resources, workers, model adapters, and end-to-end browser journeys. It distinguishes tested implementation from architectural acceptance criteria.
Representative criteria include Organization A being unable to read B’s resources; an unauthorized caller receiving no document chunks; a disabled plugin being unable to execute; a queued job losing publication rights after revocation; and a historical citation remaining inaccessible after its source permissions change. End-to-end tests should follow upload, processing, question, answer, and citation resolution with multiple synthetic identities. A successful answer alone cannot validate tenant isolation.
Architecture decision records
An ADR answers why a decision was made, including context, alternatives, consequences, and validation criteria. It preserves reasoning that a directory tree or dependency list cannot explain. A reader can understand why a boundary exists before proposing a shortcut across it.
The repository’s 30 ADRs cover the monorepo, plugin architecture, Gateway, Core, PostgreSQL and pgvector, data ownership, multi-tenancy, authentication, roles, permission-aware AI, workers, frontends, and deployment. For example, ADR-0013 establishes permission-aware AI; ADR-0009 discusses service-owned migrations; ADR-0020 separates structured analytics from documentary RAG.
Accepted architecture does not imply completed implementation. Proposed decisions retain alternatives that need validation. Reading the ADRs alongside the source and release history prevents an early design note from overriding later implementation evidence. They also record costs, making architectural change a reasoned choice rather than accidental drift.
Architecture diagram collection
The repository contains a numbered collection of 19 architecture diagrams, from global architecture to deployment. Each view answers a different question: system context and services define boundaries; the monorepo view explains organization; backend and asynchronous flows explain communication; PostgreSQL ownership explains persistence responsibilities.
Other views follow authorization, permission-aware AI, plugin lifecycle, Knowledge ingestion, secure RAG, Analytics, Orchestrator, Conversations, organization onboarding, roles and permissions, and frontend responsibilities. Together they let a reader move from product actors to one operation without relying on a single unreadable diagram.
These diagrams describe architecture and should be read with the corresponding ADRs. An illustrative box is not an approved vendor choice or proof of a running integration. The Mermaid diagrams in this article focus on the flows needed to understand the case study.
Deployment architecture
Services are designed to be independently deployable in containers, with private internal networking for backend communication. Frontend applications serve their audiences, and Gateway exposes the public API surface. Core, plugins, workers, PostgreSQL, Redis, and object storage should not become unrestricted public administration surfaces.
Each service receives validated environment configuration and narrowly scoped credentials. Liveness confirms that a process runs; readiness checks the prerequisites for serving its workload. Deployment order, compatible contracts, explicit migrations, and rollback behavior matter because components can change at different times.
The local Docker Compose stack makes PostgreSQL, Redis, and MinIO reproducible without separate host installations. Production design adds secret rotation, transport protection, backups, restore exercises, retention, and operational visibility. These responsibilities remain cloud-provider neutral: the architecture does not require a particular cloud, orchestrator, or Kubernetes deployment to explain its boundaries.
Design tradeoffs
Monorepo versus multiple repositories
One repository makes coordinated contract changes and architecture review easier. The cost is discipline around imports, build scope, and ownership. Multiple repositories make physical separation clearer but add coordination overhead for changes spanning producers and consumers.
Independent APIs versus a modular monolith
Separate APIs make domain ownership and independent deployment explicit. They introduce network latency, service authentication, compatibility management, partial failure, and operational overhead. A modular monolith could reduce those costs; Amani’s choice requires enforcing boundaries rather than assuming more services automatically improve the design.
PostgreSQL with pgvector
Relational and vector data can share established operational tooling and version metadata. This reduces the number of storage systems but does not remove workload contention, index tuning, or the need to evaluate retrieval performance. A specialized store would add another consistency and operations boundary.
Gateway and Core separation
Gateway handles external transport; Core owns platform policy. This avoids a domain-heavy edge service and keeps policy reusable by plugins, at the cost of internal calls and repeated validation where current authorization is necessary.
Shared packages
Neutral types and contracts reduce drift. Broad shared business services would couple releases and undermine ownership. Keeping packages narrow sacrifices some apparent reuse to preserve independent reasoning and deployment.
Asynchronous workers
Workers keep expensive processing out of HTTP deadlines and can scale according to workload. The cost is eventual progress, queue recovery, idempotency, status tracking, cancellation, and permission revalidation. A queue moves the failure boundary; it does not eliminate failures.
Release history
The source repository contains the following three alpha tags. They mark successive backend foundations, not a claim that the complete AI product is in production.
v0.1.0-alpha.1 — Foundation Release
The foundation establishes architecture, ADRs, diagrams, shared packages, and local infrastructure. Its purpose is to make service responsibilities, configuration, and data ownership explicit before feature-specific integrations grow.
v0.2.0-alpha.1 — Core Platform Release
Core adds persistent organizations, memberships, roles, permissions, plugin and entitlement policy, and authorization. Transactional mutations and integration tests make tenant behavior inspectable rather than leaving it as an architectural intention.
v0.3.0-alpha.1 — API Gateway Release
Gateway adds the controlled external boundary and Core integration: request context, security protections, bounded backend calls, normalized errors, deadlines, and rate limits. Local authentication and delegation support integration testing without being presented as the production IAM solution.
Development approach
The delivery order follows dependencies: architecture → shared packages → infrastructure → Core Platform → Gateway → Knowledge → workers → AI Orchestrator → remaining plugins → frontend applications. This is an engineering sequence, not a promise that every stage is already delivered.
Authorization and data ownership come before RAG because a retrieval pipeline otherwise has no reliable answer to whose data it can search. Knowledge and its worker establish traceable ingestion before synthesis depends on it. The Orchestrator can then consume explicit tools rather than embedding domain access in a prompt.
Each increment should demonstrate a complete boundary: accepted input, authorized operation, persisted result where appropriate, controlled failures, and tests. The first document-answer journey is valuable when upload, processing, retrieval, answer, and citation access work under different user scopes. Expanding plugins and interfaces builds on that evidence rather than bypassing it.
Engineering lessons
I learned to treat architecture as a way of making the next implementation decision clearer, rather than as a collection of diagrams to finish before coding. Defining bounded contexts helped me decide who owns an operation, which service can change its data, and where a permission must be checked.
Multi-tenancy made the distinction between identity and membership concrete. A valid user is not automatically authorized in an organization, and a valid organization permission is not automatically access to a document. Writing denial cases alongside successful operations exposed assumptions that a happy-path demo would hide.
Shared contracts and explicit migrations also changed how I approached change. A compile-time type does not validate an incoming response; a migration file needs controlled application and rollback behavior. Service boundaries introduce timeouts and partial failures that must be designed into the client, not handled as afterthoughts.
For AI, the strongest lesson is that security belongs in retrieval and tool execution before generation. ADRs preserve why those constraints exist. Narrow monorepo packages and incremental releases let me build and verify those foundations without claiming results for capabilities that have not been measured.
An enterprise AI platform, beyond chat
Amani IA is designed as a platform where organizations control capabilities, users receive scoped permissions, plugins own their domains, and services communicate through explicit contracts. Its conversational interface is the visible result of that architecture, not the whole system.
The coherent objective is to make company knowledge and business data useful while ensuring that AI operates only over information the requesting person may access. Documents, calculations, saved conversations, citations, and generated artifacts all belong to that same authorization model.
The source repository records the implementation and the reasoning behind these boundaries.
Security and authorization are part of the AI architecture, not a layer added after the model.
Amani IA : une IA d’entreprise aux accès maîtrisés
Amani IA est une plateforme d’IA d’entreprise multi-tenant et organisée en plugins. Elle est conçue pour relier les connaissances et les données métier d’une organisation à des capacités IA sécurisées. Chaque organisation choisit ses fonctionnalités, attribue des rôles à ses membres et conserve la maîtrise des informations accessibles à chacun.
L’IA ne doit jamais connaître ni révéler une information que l’utilisateur à l’origine de la demande n’est pas autorisé à consulter.
Deux collaborateurs de la même entreprise peuvent poser une question identique et obtenir des réponses différentes, car leurs périmètres d’autorisation diffèrent. Ce principe structure les services, les données, la recherche, les traitements de fond et les citations.
Cette étude présente l’architecture complète et les raisons de ses choix. Les releases implémentées établissent les packages partagés, l’infrastructure, le Core Platform et l’intégration Gateway ; l’architecture produit décrit le système que ces fondations doivent porter. Les schémas expliquent des responsabilités et des flux, sans attester du déploiement de chaque parcours.
Le problème : l’IA d’entreprise est aussi une question d’accès
Les connaissances d’une entreprise se répartissent entre documents, politiques internes, procédures, rapports, tableurs, jeux de données, référentiels et systèmes externes. Brancher un modèle de langage sur ces sources ne résout qu’une partie du problème. Il faut surtout déterminer qui peut lire un document, invoquer un plugin, analyser un dataset, rouvrir une conversation ou télécharger un rapport, tout en excluant les données des autres organisations.
Tout récupérer, tout transmettre au LLM puis lui demander de masquer le confidentiel est une mauvaise frontière de sécurité : l’information a déjà été communiquée au modèle. Un refus dans la réponse ne peut pas annuler cette divulgation.
Amani IA suit donc cet ordre : autoriser → filtrer → rechercher → construire le contexte → générer. Les références aux sources et les fichiers dérivés suivent la même règle. Pouvoir utiliser une fonctionnalité ne donne pas accès à toutes les ressources qu’elle contient.
Direction du produit
Le produit associe un modèle SaaS multi-tenant à des services internes déployables indépendamment, réunis dans un monorepo. Les API définissent la collaboration entre interfaces, plugins et workers. Chaque organisation choisit ses capacités parmi Knowledge, Data Analytics, Conversations, Connectors et Evaluation ; le propriétaire et les administrateurs habilités en délèguent ensuite l’usage aux membres.
Cette modularité n’a de sens que si les responsabilités restent nettes. Knowledge possède les preuves documentaires ; Analytics, les calculs structurés ; Conversations, l’historique ; Connectors, la synchronisation ; Evaluation, les vérifications de qualité reproductibles. L’AI Orchestrator coordonne ces capacités sans devenir propriétaire de leurs données.
Une installation correspond à une activation logique au niveau de l’organisation. Elle n’impose pas un conteneur de plugin par client et ne suppose pas une place de marché exécutant du code tiers arbitraire. La souplesse du produit repose sur des capacités et des contrats contrôlés.
Architecture globale
Trois applications Next.js répondent à des publics distincts : Website, Enterprise Portal et SaaS Admin. Trois services NestJS portent la plateforme : API Gateway, Core Platform API et AI Orchestrator. Cinq API de plugins NestJS possèdent les domaines métier. Document Processing et le Python Data Engine exécutent les travaux longs hors du chemin interactif.
PostgreSQL assure la persistance relationnelle, pgvector la recherche vectorielle, Redis la coordination temporaire et MinIO/S3 le stockage d’objets privés. Le schéma regroupe le stockage pour rester lisible : cela ne donne pas à chaque service accès à toutes les tables ou à tous les fichiers.
Source Mermaid
flowchart TD
  Website[Website - Next.js] --> Gateway[API Gateway - NestJS]
  Enterprise[Enterprise Portal - Next.js] --> Gateway
  Admin[SaaS Admin - Next.js] --> Gateway
  Gateway --> Core[Core Platform API]
  Gateway --> AI[AI Orchestrator]
  AI --> Core
  AI --> Knowledge[Knowledge API]
  AI --> Analytics[Data Analytics API]
  AI --> Conversations[Conversations API]
  Connectors[Connectors API] --> Knowledge
  Connectors --> Analytics
  Evaluation[Evaluation API] --> AI
  Knowledge --> Documents[Worker Document Processing]
  Analytics --> Python[Python Data Engine]
  Core --> PG[PostgreSQL - schemas propres aux services]
  Knowledge --> Vectors[PostgreSQL et pgvector]
  Analytics --> PG
  Knowledge --> Objects[MinIO ou S3]
  Analytics --> Objects
  Documents --> Redis[Redis - coordination delimitee]
  Python --> Redis
Website
Website constitue la surface publique du produit : présentation, tarification, catalogue des plugins, informations générales et entrée dans le parcours d’intégration. Il explique ce que l’organisation choisit et le rôle des capacités, sans exposer d’identifiants de services internes ni de fonctions d’administration privilégiées.
Une description commerciale d’offre reste informative. Les droits effectifs conservés par Core déterminent ce que l’organisation authentifiée peut activer. Cette distinction empêche un texte marketing ou une sélection côté navigateur de devenir une autorisation. La navigation publique conduit vers le bon parcours authentifié, sans créer un deuxième moteur de politique d’accès.
Enterprise Portal
Enterprise Portal est l’espace de travail de l’organisation cliente. Il réunit les plugins activés, l’accès aux connaissances, les datasets et analyses, les conversations et l’interaction avec l’IA. La gestion des membres, équipes, rôles et permissions s’inscrit dans ce même contexte, avec des actions adaptées aux capacités de l’utilisateur.
L’organisation sélectionnée reste explicite, notamment pour une personne membre de plusieurs entreprises. En changer modifie les ressources et opérations disponibles. Le tableau de bord est conçu pour présenter une vue de l’organisation, l’activité récente et les accès aux travaux autorisés. Masquer une commande facilite la lecture ; le backend vérifie malgré tout chaque opération.
SaaS Admin
SaaS Admin est l’interface des opérateurs de plateforme pour gérer les organisations, le registre des plugins, les parcours de modération, la gouvernance, les audits et les abonnements ou capacités commerciales. Ces responsabilités diffèrent de l’administration de l’espace interne d’un client.
Un opérateur doit disposer du contexte nécessaire pour diagnostiquer un échec de provisionnement ou gérer un abonnement sans recevoir librement les documents clients. Les actions de support et de modération demandent donc un objectif explicite, un périmètre autorisé et une trace. Un changement de statut doit se répercuter dans la politique Core et le comportement des services ; l’interface ne peut pas contourner cette politique.
Architecture frontend
Les trois applications Next.js restent volontairement séparées parce qu’elles servent des frontières de confiance et des usages différents. Website est public et principalement informatif ; Enterprise travaille dans le contexte d’une organisation ; SaaS Admin exécute des opérations de niveau plateforme. Elles peuvent partager des primitives visuelles et des clients API typés sans partager les mêmes hypothèses d’autorisation.
Le navigateur n’est jamais la source de vérité des permissions. La navigation, les boutons et les panneaux de plugins peuvent être masqués lorsqu’une capacité manque, mais chaque opération sensible est réautorisée par le backend. Les secrets serveur restent hors des bundles navigateur et les clients frontend passent par la Gateway plutôt que d’accéder aux bases ou aux endpoints internes privilégiés.
Un package UI partagé peut maintenir un langage visuel cohérent, tandis qu’un package SDK peut centraliser des clients générés ou maintenus à partir de contrats versionnés. Séparer ces préoccupations des services métier permet aux interfaces d’évoluer sans importer les mécanismes internes de Core ou des plugins.
API Gateway
Gateway est le point d’entrée externe des API. Il valide les requêtes, établit la frontière d’authentification, route des opérations explicites, transmet les identifiants de requête et de corrélation, applique CORS et les en-têtes de sécurité, limite les corps et normalise les erreurs publiques. Un en-tête d’identité reçu ne prouve pas l’identité d’un service ; les en-têtes transmis suivent une liste autorisée.
Sa responsabilité porte sur le transport, pas sur les rôles d’organisation, les documents, les datasets ou la facturation. Ces décisions appartiennent à Core et aux plugins. Cette séparation évite de dupliquer la politique métier entre le point d’entrée et le service propriétaire.
Gateway est sans état métier durable : il ne possède ni base métier ni magasin de sessions faisant autorité. Son implémentation locale conserve cependant des compteurs de débit bornés en mémoire ; ils disparaissent au redémarrage et ne constituent pas des quotas partagés entre instances. La coordination de production demande un mécanisme commun. L’intégration HTTP borne les corps, les réponses et la durée des appels, sans réessayer aveuglément les écritures.
Core Platform API
Core fait autorité sur la politique de plateforme : utilisateurs, organisations, adhésions, équipes, rôles, permissions, registre des plugins, installations par organisation, offres, capacités, abonnements et audit. Centraliser ces faits empêche chaque plugin de réinterpréter l’identité organisationnelle ou les droits commerciaux à sa manière.
Core répond aux questions de niveau organisation : l’appelant est-il un membre actif, possède-t-il la permission de l’opération et peut-il utiliser le plugin compris dans ses droits ? Le plugin vérifie ensuite l’accès à sa propre ressource. Core n’a pas besoin de posséder toutes les ACL documentaires ou tables de datasets pour rester l’autorité de politique générale.
La transaction de création implémentée établit ensemble l’organisation, l’adhésion du propriétaire, les rôles initiaux, les attributions et l’audit. Les changements sensibles revérifient la politique dans leur transaction. Un échec partiel ne doit pas laisser une organisation sans propriétaire ni valider une mutation sans son audit de réussite.
AI Orchestrator
L’Orchestrator transforme une question en plan d’exécution contrôlé. La classification d’intention distingue les demandes knowledge, appuyées sur des documents, les demandes data, nécessitant des calculs, les demandes hybrid, qui combinent les deux, et les demandes general, sans recherche privée. Cette classification choisit un parcours ; elle n’accorde aucun droit.
Le service décompose la requête, détermine les plugins et outils accessibles dans le contexte d’autorisation et organise une exécution séquentielle ou parallèle selon les dépendances. Une recherche et un calcul indépendants peuvent avancer ensemble ; un calcul dépendant d’un identifiant retrouvé doit attendre. Budgets, délais et règles d’échec partiel bornent ce travail.
Les résultats autorisés sont agrégés avec leur provenance, intégrés au prompt puis transmis au LLM par une abstraction de fournisseur. La réponse structurée contient le texte, les citations et les fichiers autorisés. L’Orchestrator possède la coordination et la synthèse ; les plugins gardent la responsabilité de leurs ressources et des décisions d’accès actuelles.
Communication entre backends
Le chemin type relie utilisateur → frontend → Gateway → Core ou Orchestrator → API de plugin → stockage propre ou worker → réponse. Un appel n’est pas fiable simplement parce qu’il reste sur le réseau interne. Chaque destinataire doit authentifier le service appelant et vérifier l’utilisateur délégué, l’organisation, l’action, le destinataire attendu et la validité du contexte.
Des contrats explicites transportent le contexte et les erreurs normalisées. Les request IDs identifient les appels ; un correlation ID relie appels et tâches d’une même opération. Les délais évitent une attente sans borne. Un contexte absent ou invérifiable provoque un refus, y compris lorsque le service de politique ne permet pas une décision fiable.
Source Mermaid
flowchart TD
  User[Utilisateur] --> Frontend[Frontend Next.js]
  Frontend --> Gateway[Gateway - authentifier et valider]
  Gateway --> Core[Core - politique de plateforme]
  Gateway --> AI[Orchestrator - plan delimite]
  AI --> Plugin[API de plugin - autoriser la ressource]
  Plugin --> Core
  Plugin --> Storage[Stockage propre]
  Plugin --> Worker[Tache de worker delimitee]
  Storage --> Response[Reponse autorisee]
  Worker --> Response
  Response --> Gateway
Ce contrat réel provient de packages/contracts/src/index.ts. Il décrit un contexte déjà vérifié ; TypeScript n’authentifie pas un appelant simplement parce qu’un objet respecte cette interface.
export interface ServiceRequestContext {
  readonly requestId: RequestId;
  readonly correlationId: CorrelationId;
  /** Identity established by service authentication, not a caller-selected name. */
  readonly callingService: ServiceName;
  readonly timestamp: IsoTimestamp;
  readonly authorization: AuthorizationContext;
}
Modèle de confiance entre services
Amani IA traite la communication interne comme un problème de délégation authentifiée et non comme un raccourci fondé sur un réseau supposé fiable. Le service destinataire doit savoir quel service appelle, quel utilisateur final est représenté, quelle organisation est active, quelle opération est demandée et si ce contexte délégué reste valide.
Le transport peut évoluer — jetons de service signés, identité de workload ou mTLS — mais le contrat sémantique reste identique : un appelant ne peut pas inventer des headers d’utilisateur, d’organisation, de rôle ou de permission. Les headers réservés sont supprimés ou remplacés à l’entrée, les services valident l’identité de l’appelant et les plugins propriétaires des ressources restent responsables de leurs propres décisions d’autorisation.
Cette approche limite aussi les attaques de type confused deputy. Un service peut être autorisé à appeler un autre service sans être autorisé à demander n’importe quelle ressource au nom de n’importe quel utilisateur. La délégation transporte donc une audience, un but, un contexte de corrélation et une durée de validité bornés plutôt qu’un privilège interne global.
Un monorepo, des frontières indépendantes
L’architecture rassemble applications, plugins, workers, primitives partagées, infrastructure et documentation dans un même dépôt. L’arborescence ci-dessous représente cette organisation, y compris les emplacements réservés comme prompts, sdk et ui ; elle ne signifie pas que chaque dossier constitue un package opérationnel. Le socle npm actif compte trois frontends, huit backends et quatre packages partagés. Les dépendances Python restent séparées des workspaces npm.
amani.ia/
├── apps/
│   ├── gateway/
│   ├── core-api/
│   ├── ai-orchestrator/
│   ├── website/
│   ├── admin/
│   └── enterprise/
├── plugins/
│   ├── knowledge/
│   ├── data-analytics/
│   ├── conversations/
│   ├── connectors/
│   └── evaluation/
├── workers/
│   ├── document-processing/
│   └── data-engine/
├── packages/
│   ├── contracts/
│   ├── types/
│   ├── config/
│   ├── shared/
│   ├── prompts/
│   ├── sdk/
│   └── ui/
├── infrastructure/
├── docs/
└── tests/
Monorepo ne signifie pas monolithe. Un même commit peut faire évoluer ensemble un contrat et ses consommateurs, mais chaque service conserve ses données, sa configuration, sa compilation et sa frontière de déploiement. Les règles d’import restent essentielles : la proximité des fichiers n’autorise pas à importer les repositories ou les mécanismes internes d’autorisation d’une autre application.
Packages partagés
@amani/types
Les identifiants et types de valeurs indépendants des frameworks fournissent un vocabulaire commun sans importer NestJS, Next.js ou un ORM. Ils décrivent des valeurs, pas des droits d’accès.
@amani/contracts
Projections d’API, enveloppes d’événements et de tâches, erreurs et contextes définissent les échanges entre services. Chaque consommateur valide les entrées à l’exécution et vérifie lui-même l’autorisation. Un contrat ne transporte pas un modèle de base de données partagé.
@amani/config
Les utilitaires de configuration typée valident valeurs obligatoires, bornes, protocoles et environnements. Une erreur désigne le paramètre invalide sans afficher sa valeur secrète. Chaque service choisit les réglages dont il a réellement besoin.
@amani/shared
De petits utilitaires indépendants des frameworks traitent des préoccupations neutres comme les identifiants de traçage. Leur périmètre reste volontairement plus étroit qu’une couche métier commune.
La règle des quatre packages est simple : les packages partagés ne doivent jamais devenir une logique métier partagée. Sinon, un import pratique finit par coupler déploiement, persistance et politique dans tout le système.
Contrats API, versionnement et frontière SDK
L’indépendance des services ne fonctionne que si leurs interfaces sont explicites. Les opérations HTTP s’appuient sur des contrats d’API versionnés, tandis que les traitements asynchrones utilisent des enveloppes d’événements et de jobs versionnées. Une rupture de compatibilité demande une stratégie de migration au lieu de modifier silencieusement un type TypeScript qui compile dans le même dépôt.
packages/contracts définit le vocabulaire partagé sur le fil ; il n’expose pas les entités ORM. packages/sdk constitue l’emplacement naturel de clients générés ou maintenus une fois les endpoints stabilisés. Un consommateur dépend d’un contrat ou d’un SDK, pas du contrôleur, du repository ou du schéma SQL du fournisseur.
Le versionnement concerne aussi les événements et les tâches, car un job en file peut survivre à un déploiement. Le producteur inclut une version d’événement ou de job, le consommateur refuse explicitement les versions non supportées et la migration des workflows longs est traitée comme un problème de compatibilité plutôt que comme un simple refactoring.
PostgreSQL et pgvector
PostgreSQL assure l’intégrité relationnelle par les clés étrangères, contraintes et transactions. Des UUID identifient les entités ; des index servent les recherches par organisation et les jointures courantes. Le JSON convient à des métadonnées bornées réellement variables, tandis qu’identités, relations, permissions et états restent explicites. Core utilise Drizzle et node-postgres pour sa propre persistance.
pgvector rapproche les vecteurs documentaires des métadonnées de version et de ressource. La similarité est un mécanisme de recherche, pas une décision d’autorisation. La sélection des candidats doit intégrer l’organisation et les ressources accessibles avant qu’un extrait ne quitte son service propriétaire.
Des comptes SQL et schémas distincts imposent la propriété par service. Six domaines disposent de schémas isolés ; l’extension réside dans un schéma dédié. Les privilèges entre services restent ainsi distincts des contrôles applicatifs entre organisations. Les migrations Core, versionnées et vérifiées par empreinte, utilisent transaction et verrou consultatif et s’exécutent explicitement, évitant une compétition implicite au démarrage.
Des données possédées par leur service
| Propriétaire | Domaine faisant autorité |
|---|---|
| Core Platform | Identités, organisations, adhésions, politique, registre, installations, abonnements, audit |
| Knowledge | Bases de connaissances, versions documentaires, droits, fragments, embeddings, provenance |
| Data Analytics | Datasets, schémas, droits sur les données, demandes d’analyse et métadonnées des résultats |
| Conversations | Fils, messages, pièces jointes et références aux sources |
| Connectors | Configuration des connexions, points de reprise et métadonnées des sources |
| Evaluation | Jeux d’évaluation, campagnes, mesures et résultats de régression |
Aucun service ne modifie directement les tables métier d’un autre. Les lire au travers de son schéma viole aussi la frontière : cela contourne sa politique de ressources et couple le consommateur à ses migrations. API, contrats versionnés et événements délimités organisent la collaboration.
La propriété couvre également suppression et conservation. Le plugin propriétaire coordonne ses lignes, objets, index et références dérivées. Les conséquences entre services demandent une propagation explicite et une réconciliation, plutôt qu’une cascade SQL cachée entre schémas.
Révocation, conservation et données dérivées
L’autorisation ne s’arrête pas à la première lecture. Si l’accès à un document ou à un dataset est révoqué, la même restriction doit s’appliquer aux recherches futures, aux résultats mis en cache, aux exports, aux références de conversation, aux citations et aux jobs asynchrones encore en cours. Un artefact généré auparavant ne doit pas devenir un contournement permanent d’une décision de politique plus récente.
Le service propriétaire définit donc les règles de conservation et de suppression des données primaires comme dérivées. Les jobs transportent le contexte du tenant et du demandeur, les caches sensibles ont une durée de vie bornée et l’accès est revérifié lors de la consommation d’un résultat lorsque l’opération peut survivre à l’autorisation initiale. Désactiver un plugin est un changement de cycle de vie, pas une demande de destruction silencieuse des données client.
Redis : coordination temporaire
Redis occupe le rôle d’infrastructure pour le cache, les files, la coordination des tâches, les états temporaires et les limites de débit distribuées. Il ne fait pas autorité sur les adhésions, permissions ou propriétaires de documents. Les compteurs actuels de Gateway restent locaux au processus ; le rôle décrit ici correspond à l’architecture de coordination commune, pas à une affirmation qu’ils utilisent déjà Redis.
Les clés doivent porter le périmètre pertinent : environnement, service, organisation, ressource ou opération et, lorsque le résultat dépend des droits, utilisateur ou version de politique. Une réponse mise en cache sous la seule question pourrait divulguer à David les sources d’Alice. Expiration et invalidation doivent suivre les changements de droits et de sources, au-delà d’une simple durée de cache.
Les files exigent aussi un contrat de livraison, des reprises bornées et une récupération durable. Choisir Redis ne choisit pas automatiquement une bibliothèque de jobs et ne garantit pas une livraison unique.
Stockage objet MinIO et S3
Le stockage objet conserve les documents originaux, fichiers de datasets, rapports, exports et fichiers générés. PostgreSQL porte leurs métadonnées, propriété, version, état de cycle de vie et références de stockage opaques. MinIO fournit un environnement local compatible S3 ; le contrat applicatif reste indépendant de l’hébergeur.
Une clé organisée par organisation, ressource et version facilite le rangement, mais son préfixe ne constitue pas une autorisation. L’API propriétaire vérifie l’appelant et la ressource avant d’accorder un téléchargement temporaire ou d’effectuer une opération de stockage. Les buckets restent privés et les identifiants du stockage ne deviennent jamais ceux du navigateur.
Rapports et graphiques dérivés reçoivent un périmètre d’accès et une expiration adaptés. Conservation, nettoyage des versions, imports abandonnés, fichiers temporaires et suppression doivent suivre des règles cohérentes : effacer une métadonnée ne doit pas laisser un objet confidentiel accessible.
Configuration, secrets et frontières d’environnement
La configuration est validée par service au démarrage. Valeurs publiques, endpoints internes, identifiants de base, clés de fournisseurs et secrets de stockage objet n’ont pas les mêmes règles d’exposition ; une valeur nécessaire côté serveur n’est pas automatiquement sûre dans un bundle navigateur. @amani/config centralise parsing et validation, tandis que chaque application ne déclare que les paramètres qu’elle consomme réellement.
Le développement local utilise des modèles .env.example revus et des services gérés par Docker. En production, les secrets doivent provenir d’un mécanisme dédié avec accès limité par service et rotation. Logs et réponses d’erreur n’affichent jamais les valeurs secrètes, headers d’autorisation, mots de passe SQL, clés de fournisseurs ni identifiants d’administration du stockage objet.
Modèle métier du Core
User représente l’identité sur la plateforme. Organization définit le tenant. Membership relie les deux ; Team organise les membres et Role regroupe des permissions. Plugin identifie une capacité ; Plugin Installation décrit son cycle de vie dans une organisation. Les offres Plan portent la dimension commerciale et les Entitlements déterminent les capacités incluses dans un abonnement valide.
Ces relations répondent à des questions différentes : qui est la personne, quelle organisation est concernée, que peut-elle faire et quelles capacités sont disponibles ? Les réunir dans un rôle global d’utilisateur ferait perdre la frontière d’organisation et compliquerait l’audit des exceptions.
Le schéma est conceptuel ; les relations multiples utilisent des tables de liaison explicites. Le regroupement en équipe n’accorde pas à lui seul une permission.
Source Mermaid
flowchart TD
  User[Utilisateur] --> Membership[Adhesion]
  Organization[Organisation] --> Membership
  Organization --> Team[Equipe]
  Team --> Membership
  Membership --> Role[Attributions de roles]
  Role --> Permission[Permissions]
  Organization --> Installation[Installation de plugin]
  Plugin[Registre des plugins] --> Installation
  Organization --> Subscription[Abonnement]
  Plan[Offre] --> Subscription
  Plan --> Entitlement[Capacites incluses]
  Entitlement --> Plugin
Adhésions et contexte d’organisation
User et Membership sont séparés parce qu’une identité peut appartenir à plusieurs organisations avec des responsabilités différentes. Alice peut être responsable RH dans l’organisation A et simple membre dans l’organisation B. Son identité reste identique ; ses permissions effectives changent avec l’organisation sélectionnée.
L’état de l’adhésion compte aussi. Sa suspension ou son retrait doit interrompre l’accès à cette organisation, même si le compte utilisateur reste actif ailleurs. Une requête ne peut donc déduire une autorité de la seule identité, d’un domaine d’adresse électronique ou du rôle le plus élevé détenu dans un autre tenant.
Chaque opération résout l’organisation et l’adhésion actuelle avant d’évaluer les rôles. Ce contexte accompagne les appels et tâches suivants, empêchant un utilisateur valide de substituer l’identifiant d’une ressource appartenant à une autre organisation.
Rôles et permissions
Owner, Admin et Member fournissent des points de départ organisationnels. Les rôles personnalisés expriment des responsabilités comme la gestion RH ou documentaire. Une adhésion peut cumuler plusieurs rôles, dont les permissions sont résolues dans son organisation. Le refus par défaut signifie qu’un droit absent entraîne un refus, sans inférence à partir d’un intitulé de poste.
Core comprend members.read, members.manage, roles.manage, plugins.use et plugins.manage. Des capacités comme documents.read et datasets.read illustrent le vocabulaire de permissions des plugins ; elles demandent encore une vérification sur le document ou le dataset concerné.
La délégation doit elle-même être autorisée. Un gestionnaire de rôles non propriétaire ne peut pas accorder davantage que son autorité, l’attribution d’un administrateur dépend du propriétaire et les opérations ordinaires protègent la propriété. L’éditeur de rôles doit rendre lisibles l’opération permise et son périmètre organisationnel.
Rôles de plateforme et rôles d’organisation
Un administrateur de plateforme Amani gère le SaaS. Un propriétaire ou administrateur d’organisation gère l’espace d’un client. Ces qualités peuvent coexister sur un compte, mais elles appartiennent à des domaines d’autorisation distincts.
Les privilèges de plateforme ne donnent pas automatiquement une adhésion dans toutes les organisations ni le droit d’en lire les documents. Le support exige un parcours explicite, limité et audité ; un rôle global ne doit pas devenir un contournement invisible des droits sur les données. Inversement, posséder une organisation ne permet pas de modifier le registre global des plugins ou l’abonnement d’un autre client.
Cette séparation rend les attentes des utilisateurs et les tests de politique plus précis.
Parcours d’autorisation
L’autorisation est une chaîne de vérifications, pas un booléen stocké sur l’utilisateur. Il faut établir l’identité, résoudre l’organisation, vérifier l’adhésion active, calculer les rôles et permissions, contrôler disponibilité et droits du plugin, puis autoriser la ressource demandée. Toute condition non satisfaite arrête l’accès aux données.
Gateway peut rejeter tôt, mais le service propriétaire reste responsable de la décision actuelle. Une ancienne requête réussie, une entrée de cache ou un job en attente ne constitue pas un droit permanent. Une mutation peut demander une nouvelle vérification dans sa transaction ; télécharger une citation exige un nouveau contrôle de ressource.
Source Mermaid
flowchart TD
  Request[Requete] --> Identity[Identite verifiee]
  Identity --> Organization[Organisation selectionnee]
  Organization --> Membership[Adhesion active]
  Membership --> Roles[Roles effectifs]
  Roles --> Permissions[Permission de l operation]
  Permissions --> Plugin[Etat du plugin et capacites]
  Plugin --> Resource[Autorisation actuelle de la ressource]
  Resource --> Result[Operation et resultat delimites]
  Identity -.-> Deny[Refuser tout controle echoue ou invérifiable]
  Membership -.-> Deny
  Permissions -.-> Deny
  Plugin -.-> Deny
  Resource -.-> Deny
Une IA qui respecte les permissions
Alice et David appartiennent à la même organisation et demandent : « Qu’est-ce qui explique la hausse des coûts de personnel ? » Alice peut consulter les rapports de rémunération RH. David accède aux rapports généraux d’effectifs et de projets, mais pas à la paie. Une question commune n’implique pas des sources communes.
Le contexte autorisé d’Alice peut comprendre des évolutions salariales. Celui de David doit exclure documents de paie, colonnes de salaires, extraits restreints et fichiers dérivés révélant ces valeurs. Sa réponse peut commenter les effectifs accessibles ou expliquer que les sources disponibles ne suffisent pas. Elle ne doit pas suggérer des chiffres confidentiels au travers d’une citation interdite ou d’un agrégat révélateur.
Même question + même organisation + permissions différentes = contextes autorisés différents = réponses potentiellement différentes. Le filtrage précède recherche et calcul ; les caches doivent préserver cette distinction. Une révocation affecte également les références sauvegardées et les tours de conversation suivants.
Le LLM n’est pas la frontière de sécurité.
Source Mermaid
flowchart TD
  Question[Meme question dans la meme organisation] --> Alice[Alice - perimetre RH]
  Question --> David[David - perimetre general]
  Alice --> HR[Sources RH et generales autorisees]
  David --> General[Sources generales autorisees uniquement]
  HR --> ContextA[Contexte d Alice]
  General --> ContextD[Contexte de David]
  ContextA --> AnswerA[Reponse avec preuves RH autorisees]
  ContextD --> AnswerD[Reponse limitee aux preuves generales]
Architecture des plugins : six conditions distinctes
L’accès à une capacité répond à six questions séparées :
- Le plugin existe-t-il et reste-t-il disponible dans le registre de plateforme ?
- Est-il compris dans les droits de cette organisation sous un abonnement valide ?
- Une installation est-elle enregistrée pour l’organisation ?
- Cette installation est-elle activée et opérationnellement active ?
- Cet utilisateur peut-il invoquer le plugin ?
- Peut-il accéder à la ressource et effectuer l’opération demandées ?
Le catalogue décrit la disponibilité, l’offre l’éligibilité commerciale, l’installation la configuration organisationnelle et la politique utilisateur/ressource l’usage effectif. Aucun niveau ne remplace le suivant. Activer Knowledge ne doit pas rendre tous les documents de l’entreprise accessibles à chaque membre.
Core possède la politique de registre et d’installation ; le plugin possède ses ressources. Un manifeste décrit version, compatibilité, permissions et dépendances comme métadonnées validées, sans constituer une autorisation exécutable.
Cycle de vie d’un plugin
Une capacité enregistrée peut être choisie par une organisation, entrer en attente, être provisionnée puis devenir active. La suspension bloque l’usage en conservant le contexte. La désactivation retire l’accès sans effacer silencieusement les données du client. Un échec de provisionnement doit rester visible et récupérable par une commande idempotente.
Il s’agit de branches, pas d’un passage obligatoire de l’état actif par tous les états d’échec. Dans Core, l’installation en attente porte le nom requested ; l’enregistrement au catalogue reste distinct. Le nettoyage utilise deprovisioning, avec conservation et purge explicites. Modifier l’état de pilotage ne prouve pas à lui seul que les ressources ont été provisionnées.
Source Mermaid
flowchart TD
  Registry[Enregistre au catalogue] --> Pending[Demande en attente - requested]
  Pending --> Provision[Provisionnement]
  Provision --> Active[Actif]
  Provision --> Failed[Echec]
  Failed --> Provision
  Active --> Suspended[Suspendu]
  Suspended --> Active
  Active --> Disabled[Desactive]
  Suspended --> Disabled
  Disabled --> Cleanup[Deprovisionnement selon la conservation]
Création et intégration d’une organisation
L’intégration transforme un compte authentifié en espace d’organisation utilisable. La création établit atomiquement le propriétaire et la politique de base. Le choix de l’offre détermine ensuite les plugins éligibles ; invitations et attributions de rôles déterminent qui peut les utiliser. Un membre invité ne doit pas recevoir un accès étendu du seul fait que le parcours a réussi.
Le parcours produit dépasse une transaction unique. Facturation externe et provisionnement demandent des états visibles, des reprises et des compensations, sans prétendre qu’un rollback SQL annule tous les effets distants. La progression doit refléter les étapes terminées, et reprendre un échec ne doit pas créer d’organisations ou d’installations en double.
Source Mermaid
flowchart TD
  Account[Compte authentifie] --> Organization[Creer l organisation]
  Organization --> Owner[Etablir proprietaire et politique initiale]
  Owner --> Plan[Choisir offre et capacites]
  Plan --> Plugins[Selectionner et activer les plugins]
  Plugins --> Invitations[Inviter les membres]
  Invitations --> Roles[Attribuer les roles]
  Roles --> Permissions[Verifier les permissions effectives]
  Permissions --> Workspace[Ouvrir l espace autorise]
Plugin Knowledge
Knowledge est conçu autour des bases de connaissances, métadonnées documentaires, versions, références de stockage, permissions, orchestration d’ingestion, fragments, embeddings, recherche et citations. Les premiers formats documentaires sont PDF, DOCX, TXT et Markdown. L’original reste traçable indépendamment de sa représentation extraite.
Un document ne se réduit pas à du texte importé. Son organisation, sa version, sa politique d’accès, son état de traitement et sa référence source expliquent à la fois ce qu’une réponse utilise et pourquoi l’appelant peut l’utiliser. Chaque fragment conserve assez de provenance pour retrouver la source et sa frontière d’accès.
Knowledge possède ce cycle de vie et expose des opérations autorisées par son API. L’Orchestrator consomme des preuves sélectionnées ; il ne devient ni le dépôt documentaire ni un deuxième moteur de politique Knowledge.
Ingestion documentaire
L’ingestion vérifie l’appelant, le type et la taille du fichier ainsi que la base cible avant d’accepter l’import. Elle conserve l’original privé dans MinIO/S3 et enregistre des métadonnées versionnées avant de programmer une tâche délimitée. Le worker extrait, normalise, découpe et vectorise le contenu, puis prépare l’index sous la responsabilité de Knowledge.
Les écritures SQL et objet ne forment pas une transaction atomique unique. Un cycle robuste conserve les états intermédiaires et réconcilie objets abandonnés ou tâches incomplètes. Une version devient recherchable lorsque métadonnées et index autorisé sont cohérents. Un retraitement doit remplacer ou versionner les dérivés plutôt que les dupliquer indéfiniment.
Source Mermaid
flowchart TD
  Upload[Import] --> Validate[Valider identite fichier et cible]
  Validate --> MinIO[Original prive dans MinIO ou S3]
  MinIO --> Metadata[Metadonnees documentaires versionnees]
  Metadata --> Job[Tache d ingestion delimitee]
  Job --> Worker[Worker documentaire]
  Worker --> Extract[Extraction]
  Extract --> Normalize[Normalisation]
  Normalize --> Chunk[Decoupage avec provenance]
  Chunk --> Embed[Generation des embeddings]
  Embed --> Index[Index pgvector possede par Knowledge]
  Index --> Search[Version autorisee recherchable]
Worker Document Processing
Le worker documentaire sépare extraction coûteuse, normalisation, découpage, embeddings et préparation d’index du temps de réponse de l’API. Celle-ci accepte un travail borné et expose son état ; le worker l’exécute avec des limites de ressources et de durée.
La normalisation doit préserver la provenance utile, notamment le lien avec les pages ou sections. Le découpage équilibre contexte recherchable et traçabilité. Les tâches d’embeddings rattachent leur résultat à une version documentaire et à une configuration de modèle, évitant de mélanger silencieusement des vecteurs incompatibles lors d’une réindexation.
Le worker publie son état selon un contrat respectant la propriété des données. Il ne reçoit pas un accès universel aux organisations et schémas. Un document invalide produit un échec visible ; les reprises conservent la même opération logique et revérifient l’accès avant de publier les résultats.
Parcours RAG sécurisé
La génération augmentée par recherche relie une question à des éléments pertinents. Dans Amani IA, Gateway établit l’appelant, l’Orchestrator transmet son contexte d’autorisation et Knowledge effectue une recherche filtrée par organisation et ressource. Seuls fragments autorisés, provenance et références de citation entrent dans le prompt.
Le modèle peut synthétiser les éléments fournis, mais pas élargir les droits. Le texte retrouvé est un contenu non fiable, pas une source d’instructions privilégiées. Une instruction injectée dans un document ne doit pas autoriser un nouvel outil ou une nouvelle ressource. La réponse signale l’insuffisance des preuves lorsque nécessaire, et l’ouverture d’une citation revérifie l’accès à la source.
Source Mermaid
flowchart TD
  Question[Question] --> Gateway[Gateway]
  Gateway --> AI[Orchestrator]
  AI --> Auth[Verifier organisation plugin et perimetre]
  Auth --> Knowledge[Knowledge API]
  Knowledge --> Search[Recherche vectorielle filtree]
  Search --> Chunks[Fragments autorises]
  Chunks --> Citations[Versions sources et references]
  Citations --> Prompt[Contexte de prompt borne]
  Prompt --> LLM[Generation LLM]
  LLM --> Answer[Reponse appuyee sur les sources]
  Answer --> Open[Reautoriser l ouverture des citations]
Abstraction des fournisseurs IA
Des frontières de fournisseurs distinctes couvrent génération LLM, embeddings et reranking optionnel. L’application décrit l’opération attendue ; un adaptateur gère format de requête, identifiants, conversion des réponses, délais et comptabilisation de l’usage. Un SDK fournisseur ne doit pas définir la politique de permissions de la plateforme.
Cette séparation facilite les doubles de test déterministes, les comparaisons et les choix de déploiement sans disperser un fournisseur dans les plugins. Elle ne rend pas les modèles interchangeables sans conséquences : limites de contexte, formats de sortie, dimensions vectorielles, tokenisation, conditions de confidentialité et qualité varient. Changer de modèle d’embeddings peut exiger une réindexation ; un reranker ne reçoit que des candidats déjà autorisés.
Le choix du fournisseur relève donc aussi de l’évaluation et des contraintes d’exploitation, pas seulement d’un nom de modèle configurable.
Gouvernance des prompts et des modèles
Les prompts sont traités comme des actifs applicatifs versionnés plutôt que comme des chaînes dispersées dans les contrôleurs. Instructions système, formatage du contexte récupéré, exigences de citation et modèles propres aux tâches restent derrière des interfaces explicites afin que leurs changements puissent être relus, testés et associés aux résultats d’évaluation.
Le choix du modèle reste une politique d’exécution. Des tâches différentes peuvent utiliser des fournisseurs ou classes de modèles différents selon capacité, latence, coût ou contraintes de gouvernance des données. Aucun de ces réglages ne peut accorder un accès : la frontière d’autorisation est déjà appliquée avant la construction du prompt.
Plugin Data Analytics
Data Analytics possède les datasets CSV/XLSX, références de stockage, schémas détectés, métadonnées de profilage, permissions, demandes d’analyse et métadonnées des résultats. Le profilage expose types de colonnes, valeurs manquantes et limites utiles avant l’exécution. Des données structurées demandent des calculs reproductibles, plutôt qu’une conversion systématique de chaque cellule en texte pour le RAG.
L’autorisation couvre le dataset, l’opération et les restrictions de lignes ou colonnes applicables. Les projections sensibles sont retirées avant transmission au moteur. Les agrégations demandent aussi de la prudence : un total sur un petit groupe peut divulguer une information malgré le masquage des lignes. Résultats, visualisations et téléchargements conservent leur politique d’accès.
Source Mermaid
flowchart TD
  File[CSV ou XLSX] --> Storage[Stockage objet prive]
  Storage --> Metadata[Metadonnees et schema du dataset]
  Metadata --> Profile[Profilage]
  Profile --> Auth[Autoriser dataset operation lignes et colonnes]
  Auth --> Plan[Plan d analyse valide]
  Plan --> Python[Python Data Engine]
  Python --> Result[Resultat et provenance]
  Result --> Visualization[Visualisation ou export autorise]
  Result --> Response[Reponse structuree et explication]
Python Data Engine
Le moteur sépare l’écosystème analytique Python du runtime API Node.js. Pandas et Polars sont des options pour le traitement tabulaire ; DuckDB peut servir les requêtes analytiques locales lorsque la charge le justifie. Il ne s’agit pas d’exécuter toutes ces bibliothèques pour chaque tâche. FastAPI convient si une frontière HTTP authentifiée est retenue ; un protocole de file documenté fournit une autre possibilité de transport.
Les contrats Node/Python décrivent version du dataset, projection autorisée, filtres validés, opération, limites, identité de tâche et forme du résultat. Le LLM peut proposer une intention d’analyse ; le backend la traduit en opération déterministe explicitement permise. Il ne laisse pas choisir librement chemins, connexions SQL, modules ou destinations réseau.
Du Python arbitraire généré par un LLM ne doit pas s’exécuter sur les données clients sans isolation forte. La conception initiale évite ce modèle et limite mémoire, durée, fichiers, réseau et entrées, même pour les opérations approuvées. Les sorties temporaires demandent nettoyage et nouvelle autorisation avant publication.
Plugin Conversations
Conversations possède fils, messages, historique, pièces jointes, citations et références de ressources. Il conserve assez de provenance pour expliquer une réponse sans transformer l’historique en copie illimitée de toutes les sources. La propriété et le partage d’une conversation restent distincts des droits sur chaque document joint ou fichier généré.
Rouvrir une conversation est une opération d’autorisation. Si Alice perd l’accès à un rapport cité, sa présence dans une ancienne réponse ne doit pas rétablir ce droit. Contexte transmis lors des échanges suivants, exports, pièces jointes et citations nécessitent des contrôles actuels et une politique explicite sur le texte des réponses conservées.
Le cycle de conversation distingue également requête acceptée, sortie partielle, réponse terminée et échec. Enregistrer un message ne prouve pas qu’un outil a réussi ni que toutes les preuves citées restent disponibles.
Connectors
Connectors relie des sources d’entreprise externes au moyen de configurations propres à l’organisation. Une connexion décrit l’identité de la source, son périmètre autorisé, la politique de synchronisation, les points de reprise et des références aux identifiants protégés. Des identifiants et versions stables permettent déduplication et mise à jour sans dépendre d’un nom affiché.
Le connecteur transmet les documents à Knowledge ou les datasets à Analytics par leurs contrats. Il ne modifie pas directement leurs tables. La synchronisation doit préserver les permissions de source et propager révocations, suppressions et changements de version ; importer un contenu ne doit pas élargir silencieusement son audience.
Les adaptateurs propres aux fournisseurs se placent derrière cette frontière. Restrictions réseau, rotation des secrets, authenticité des webhooks, pagination bornée, reprises et réconciliation font partie du contrat. L’architecture évite de promettre un fournisseur précis avant validation de son modèle d’accès et de sa synchronisation.
Plugin Evaluation
Evaluation rend les changements de qualité observables et reproductibles. Les jeux d’évaluation associent questions, preuves autorisées, propriétés attendues et périmètres d’utilisateurs synthétiques. Les campagnes comparent qualité de recherche, appui sur les sources, citations, comportement, latence et coût, en conservant les versions du modèle, du prompt et de l’index.
Une réponse fluide ne suffit pas. Les tests doivent distinguer preuve pertinente manquante, affirmation sans appui, citation trompeuse et divulgation non autorisée. Comparer une même question sous des permissions différentes détecte des régressions qu’un simple benchmark de pertinence manquerait.
L’évaluation utilise les interfaces de service avec des identités bornées, sans contourner la politique par SQL. Les résultats demandent des entrées reproductibles et des échecs examinables. Cette démarche définit comment mesurer le progrès ; elle n’invente ni score de qualité, ni benchmark de production, ni résultat client.
Traitements asynchrones
Une API valide et accepte une tâche, place un message délimité dans une file et renvoie une référence de job. Un worker traite ce message, enregistre progression et résultats par le contrat du propriétaire, puis expose l’issue. Le travail coûteux sort ainsi du délai HTTP sans perdre sa traçabilité.
Les reprises conservent l’identité du job et utilisent l’idempotence lorsque nécessaire. Le correlation ID relie acceptation, exécution et publication. Le périmètre d’organisation est obligatoire ; l’autorisation est revérifiée à l’exécution et avant publication, car adhésion ou droits de source peuvent changer pendant l’attente. Les échecs demandent un nombre de tentatives borné et un état terminal inspectable.
Source Mermaid
flowchart TD
  API[API valide et accepte] --> Queue[Message de file delimite]
  Queue --> Worker[Worker revalide le perimetre]
  Worker --> Process[Traitement borne et idempotent]
  Process --> Result[Resultat et etat du proprietaire]
  Process --> Retry[Politique de reprise ou echec terminal]
  Retry --> Queue
  Result --> Access[Reautoriser l acces au resultat]
Cette interface réelle JobMetadata, issue de packages/contracts/src/index.ts, conserve provenance et métadonnées d’exécution. Elle ne constitue pas un instantané fiable des droits et ne remplace pas le protocole de livraison de la file.
export interface JobMetadata {
  readonly jobId: JobId;
  readonly jobType: string;
  /** Positive integer schema version. */
  readonly jobVersion: number;
  readonly organizationId: OrganizationId;
  readonly requestedBy: UserId;
  readonly correlationId: CorrelationId;
  readonly createdAt: IsoTimestamp;
  /** One-based execution attempt; retries retain the same jobId. */
  readonly attempt: number;
  readonly owner: ServiceName;
  readonly resourceId?: ResourceId;
  readonly action?: string;
  readonly resourceVersion?: string;
  readonly idempotencyKey?: string;
  readonly expiresAt?: IsoTimestamp;
}
Gestion des erreurs et résilience
| Situation | Comportement public |
|---|---|
| Appelant authentifié sans permission | Refus 403 sans révéler les détails d’une ressource protégée |
| Réponse amont invalide ou contrat malformé | Erreur backend normalisée de catégorie 502 |
| Backend requis indisponible | Indisponibilité contrôlée de catégorie 503 |
| Délai d’appel dépassé | Timeout 504 accompagné d’identifiants de traçage |
Ces catégories expriment la sémantique ; le mapping exact appartient au contrat validé de chaque endpoint. Erreurs SQL brutes, corps fournisseurs, piles d’exécution et secrets ne doivent pas franchir la frontière publique. Une réponse HTTP réussie mais malformée reste un échec de contrat, pas une donnée fiable à relayer.
Les appels ont des délais et des tailles de réponse bornés. Une opération non idempotente ne se réessaie pas aveuglément : le timeout peut survenir après validation de l’écriture distante. La reprise exige une identité d’opération, un contrat d’idempotence ou une réconciliation. Un mode dégradé ne doit jamais supprimer l’autorisation parce que Core est indisponible.
Observabilité
Un événement opérationnel utile identifie request ID, correlation ID, service, environnement, route, statut et durée. Des métadonnées minimales d’organisation ou d’utilisateur facilitent une investigation si leur accès est autorisé, avec pseudonymisation lorsque nécessaire et conservation justifiée. La corrélation relie requête frontend, appels backend et traitements asynchrones sans enregistrer leurs contenus.
Tokens, mots de passe, secrets, texte documentaire et datasets confidentiels ne doivent jamais entrer dans les logs ordinaires. Journaliser tout le corps pour comprendre un échec contredirait la confidentialité. Prompts et réponses brutes des fournisseurs demandent la même protection que les preuves sensibles qu’ils contiennent.
Les contrôles de santé distinguent vie du processus et disponibilité des dépendances. Métriques et traces aident à diagnostiquer recherche lente, accumulation des jobs, pannes et coût des appels IA. L’audit sert la responsabilité des changements sensibles ; il ne se confond ni avec le debug détaillé ni avec la preuve d’une collecte de télémétrie entièrement déployée.
CI/CD et ingénierie des releases
Le pipeline du monorepo valide les frontières qui rendent le déploiement indépendant sûr : lint, vérification de types, tests unitaires et d’intégration, compatibilité des contrats, build et construction des conteneurs. Une évolution d’un contrat partagé peut ainsi être vérifiée contre plusieurs consommateurs avant de couper une release.
Les services sont versionnés et déployés indépendamment même s’ils partagent un historique Git. Les migrations de base constituent des étapes de déploiement explicites appartenant au service propriétaire du schéma. Une release ne suppose pas que tous les services changent au même instant : compatibilité descendante et ordre de rollout contrôlé restent importants.
Les contrôles de sécurité appartiennent au même chemin de livraison : revue des dépendances, hygiène des secrets, scan des conteneurs lorsqu’il est disponible et tests centrés sur la politique empêchent la CI de devenir une simple vérification de compilation.
Modèle de sécurité
La conception combine des contrôles indépendants plutôt que de faire confiance à un seul composant :
- Refus par défaut et moindre privilège : sans droit vérifiable, l’opération s’arrête ; les identifiants d’un service ne permettent que ses besoins propres.
- Isolation des organisations et propriété des données : requêtes et contrôles de ressources imposent le contexte d’organisation ; les rôles SQL distincts empêchent l’accès aux tables des autres services.
- Backends authentifiés : position réseau et en-têtes déclaratifs ne prouvent rien. Identité de service et délégation utilisateur bornée doivent être vérifiées.
- Autorisations de plugin et de ressource : disponibilité, droits commerciaux, permission de l’utilisateur et périmètre documentaire restent séparés.
- Autorisation avant l’IA : recherche, reranking, analyse, construction du prompt et citations restent dans les preuves permises.
- Caches et tâches délimités : résultats conservés et traitements différés préservent organisations et droits, avec invalidation et nouvelles vérifications après changement.
- Audit sûr et secrets protégés : conserver les métadonnées nécessaires, protéger les identifiants et exclure les contenus sensibles des logs et bundles frontend.
Le LLM ne peut pas assouplir ces règles. Sa sortie et les instructions retrouvées restent des entrées non fiables pour une logique applicative contrôlée. Ces propriétés demandent des tests de refus, y compris les divulgations indirectes par agrégats, historique, pièces jointes et exports.
Stratégie de tests
Les tests suivent la frontière que l’on veut démontrer. Les tests unitaires couvrent utilitaires déterministes et décisions de politique. Les tests de service et de domaine exercent cycles de vie et transactions. L’intégration avec une vraie base vérifie contraintes, migrations, privilèges de schéma et rollback. Les tests HTTP et de contrat contrôlent parsing, projections publiques, rejets d’authentification et erreurs normalisées.
Les suites Core et Gateway implémentées exercent l’intégration backend et les refus organisationnels. La stratégie produit étend ces preuves aux ressources des plugins, workers, adaptateurs IA et parcours navigateur de bout en bout. Elle distingue l’implémentation vérifiée des critères d’acceptation architecturaux.
Exemples : A ne peut pas lire les ressources de B ; un utilisateur non habilité ne reçoit aucun fragment ; un plugin désactivé ne s’exécute pas ; un job perd son droit de publication après révocation ; une ancienne citation reste inaccessible après modification des droits de source. Les tests de bout en bout suivent import, traitement, question, réponse et ouverture de citation avec plusieurs identités synthétiques. Une réponse réussie ne suffit pas à démontrer l’isolation.
Décisions d’architecture : les ADR
Une ADR répond à la question pourquoi cette décision a été prise, avec contexte, alternatives, conséquences et critères de validation. Elle conserve un raisonnement que l’arborescence ou la liste des dépendances ne suffit pas à expliquer. Le lecteur comprend pourquoi une frontière existe avant de proposer de la contourner.
Les 30 ADR du dépôt couvrent monorepo, plugins, Gateway, Core, PostgreSQL et pgvector, propriété des données, multi-tenancy, authentification, rôles, IA sensible aux permissions, workers, frontends et déploiement. ADR-0013 établit ainsi le principe d’IA autorisée ; ADR-0009 traite des migrations propres aux services ; ADR-0020 distingue analyse structurée et RAG documentaire.
Une architecture acceptée n’implique pas une implémentation terminée. Une décision proposée garde des alternatives à valider. Lire ADR, sources et releases ensemble évite qu’une ancienne note de conception masque les preuves d’implémentation plus récentes. Les coûts sont eux aussi consignés : faire évoluer l’architecture devient un choix argumenté, pas une dérive accidentelle.
Collection de schémas d’architecture
Le dépôt contient une collection numérotée de 19 schémas, de l’architecture globale au déploiement. Chaque vue répond à une question : contexte et services définissent les frontières ; monorepo explique l’organisation ; communications backend et traitements asynchrones montrent les échanges ; propriété PostgreSQL explique la persistance.
Les autres vues suivent autorisation, IA respectant les droits, cycle des plugins, ingestion Knowledge, RAG sécurisé, Analytics, Orchestrator, Conversations, intégration d’organisation, rôles et permissions, puis responsabilités frontend. L’ensemble permet de passer des acteurs produit à une opération précise sans dépendre d’un schéma unique illisible.
Ces vues décrivent l’architecture et se lisent avec les ADR correspondantes. Une boîte illustrative ne constitue ni un choix fournisseur approuvé ni la preuve d’une intégration en fonctionnement. Les diagrammes Mermaid de cet article se concentrent sur les flux utiles à la compréhension de l’étude.
Architecture de déploiement
Les services sont conçus pour être déployés indépendamment en conteneurs, avec un réseau interne privé pour les échanges backend. Les frontends servent leurs publics et Gateway expose la surface API publique. Core, plugins, workers, PostgreSQL, Redis et stockage objet ne doivent pas devenir des interfaces d’administration librement accessibles.
Chaque service reçoit une configuration validée et des identifiants limités. La liveness confirme que le processus tourne ; la readiness vérifie les prérequis de sa charge. Ordre de déploiement, compatibilité des contrats, migrations explicites et retour arrière comptent, car les composants peuvent évoluer à des moments différents.
Docker Compose rend PostgreSQL, Redis et MinIO reproductibles en local sans installations séparées sur l’hôte. L’exploitation ajoute rotation des secrets, protection du transport, sauvegardes, exercices de restauration, conservation et visibilité opérationnelle. Ces responsabilités restent indépendantes du cloud : aucun fournisseur, orchestrateur ou déploiement Kubernetes particulier n’est nécessaire pour expliquer les frontières.
Choix de conception et compromis
Monorepo ou dépôts multiples
Un dépôt unique facilite les changements coordonnés de contrats et les revues d’architecture. Il exige en échange une discipline sur les imports, la portée des builds et la propriété. Des dépôts multiples rendent la séparation physique plus visible, mais augmentent la coordination lorsqu’un producteur et ses consommateurs évoluent ensemble.
API indépendantes ou monolithe modulaire
Des API séparées explicitent domaines et déploiement indépendant. Elles introduisent latence réseau, authentification interservices, compatibilité, échecs partiels et coûts d’exploitation. Un monolithe modulaire pourrait réduire ces coûts ; le choix d’Amani demande d’imposer les frontières, sans supposer que davantage de services améliore automatiquement la conception.
PostgreSQL avec pgvector
Données relationnelles et vectorielles partagent les outils d’exploitation et les métadonnées de version. Cela réduit le nombre de stockages, sans supprimer contention, réglage des index ni évaluation de la recherche. Un stockage spécialisé ajouterait une autre frontière de cohérence et d’exploitation.
Séparation Gateway et Core
Gateway traite le transport externe ; Core possède la politique de plateforme. Cela évite un point d’entrée chargé de métier et permet aux plugins de réutiliser la politique, au prix d’appels internes et de validations répétées lorsque l’autorisation actuelle est nécessaire.
Packages partagés
Types et contrats neutres réduisent les divergences. Des services métier communs trop larges coupleraient les releases et affaibliraient la propriété. Garder les packages étroits renonce à certaines mutualisations apparentes pour conserver un raisonnement et un déploiement indépendants.
Workers asynchrones
Les workers sortent les traitements coûteux des délais HTTP et adaptent leurs ressources à la charge. En échange, il faut gérer progression différée, récupération des files, idempotence, états, annulation et nouvelles vérifications des droits. Une file déplace la frontière de panne ; elle ne supprime pas les échecs.
Historique des releases
Le dépôt source contient les trois tags alpha suivants. Ils marquent des fondations backend successives, sans affirmer que le produit IA complet est en production.
v0.1.0-alpha.1 — Foundation Release
Le socle établit architecture, ADR, schémas, packages partagés et infrastructure locale. Il rend explicites responsabilités, configuration et propriété des données avant que les intégrations fonctionnelles ne se multiplient.
v0.2.0-alpha.1 — Core Platform Release
Core apporte organisations persistantes, adhésions, rôles, permissions, politique des plugins et des capacités, puis autorisation. Mutations transactionnelles et tests d’intégration rendent le comportement des tenants vérifiable, au-delà de l’intention architecturale.
v0.3.0-alpha.1 — API Gateway Release
Gateway ajoute la frontière externe contrôlée et l’intégration Core : contexte de requête, protections, appels backend bornés, erreurs normalisées, délais et limites de débit. Authentification et délégation locales permettent les tests d’intégration, sans être présentées comme la solution IAM de production.
Démarche de développement
L’ordre de livraison suit les dépendances : architecture → packages partagés → infrastructure → Core Platform → Gateway → Knowledge → workers → AI Orchestrator → autres plugins → applications frontend. C’est une séquence d’ingénierie, pas l’affirmation que toutes les étapes sont déjà livrées.
Autorisation et propriété des données précèdent le RAG, car un moteur de recherche a besoin de savoir dans quelles données il peut chercher. Knowledge et son worker établissent une ingestion traçable avant que la synthèse en dépende. L’Orchestrator peut alors consommer des outils explicites plutôt que cacher l’accès métier dans un prompt.
Chaque incrément doit démontrer une frontière complète : entrée acceptée, opération autorisée, résultat persisté si nécessaire, échecs contrôlés et tests. Le premier parcours documentaire prend sa valeur lorsque import, traitement, recherche, réponse et citation fonctionnent sous des droits différents. Étendre plugins et interfaces s’appuie sur ces preuves au lieu de les contourner.
Enseignements d’ingénierie
J’ai appris à utiliser l’architecture pour clarifier la prochaine décision d’implémentation, plutôt qu’à la considérer comme une collection de schémas à terminer avant de coder. Définir les domaines m’a aidé à déterminer qui possède une opération, quel service peut modifier ses données et où vérifier une permission.
Le multi-tenant a rendu concrète la différence entre identité et adhésion. Un utilisateur valide n’est pas automatiquement autorisé dans une organisation, et une permission organisationnelle ne donne pas automatiquement accès à un document. Écrire les refus à côté des parcours réussis a fait apparaître des hypothèses qu’une démonstration heureuse aurait masquées.
Contrats partagés et migrations explicites ont aussi changé ma façon d’aborder les évolutions. Un type compilé ne valide pas une réponse entrante ; une migration demande une application contrôlée et un comportement d’annulation. Les frontières de services introduisent délais et échecs partiels, à prendre en compte dans le client dès sa conception.
Pour l’IA, l’enseignement principal est de placer la sécurité dans la recherche et l’exécution des outils avant la génération. Les ADR conservent les raisons de ces contraintes. Des packages étroits et des releases progressives me permettent de construire et vérifier le socle sans revendiquer des résultats pour des capacités encore non mesurées.
Une plateforme d’IA d’entreprise au-delà du chat
Amani IA est conçue comme une plateforme où les organisations contrôlent leurs capacités, les utilisateurs reçoivent des permissions délimitées, les plugins possèdent leurs domaines et les services communiquent par des contrats explicites. L’interface conversationnelle est le résultat visible de cette architecture, pas le système entier.
L’objectif commun consiste à rendre utiles connaissances et données métier tout en limitant l’IA aux informations que la personne peut consulter. Documents, calculs, conversations conservées, citations et fichiers générés relèvent du même modèle d’autorisation.
Le dépôt source conserve l’implémentation et le raisonnement qui justifie ces frontières.
La sécurité et l’autorisation font partie de l’architecture de l’IA, pas d’une couche ajoutée après le modèle.